Skill 从入门到精通——第四章 Anthropic 官方Skill解析—skill-creator Skill 解析
4.1.17 skill-creator Skill 解析—Skill 开发、评估与优化
一、技能概述
skill-creator 是 Anthropic 官方推出的元技能(Meta-Skill),即用来创建 Skill 的 Skill——用于从创建、评估、优化到打包分发Skill的全流程。涵盖技能开发全生命周期:
- 从零创建新 Skill:从零引导用户明确使用意图、编写
SKILL.md规范、组织目录结构。 - 评估:通过子代理并行执行测试用例、量化评分结果。
- 迭代改进:通过测试→评估→反馈→修改的循环,迭代优化技能内容,持续提升 Skill 的质量。
- 描述优化:通过触发率评估 + 自动改进循环优化 description 字段,提升技能触发准确性。
- 打包分发:将技能目录一键封装为
.skill格式安装包,便捷部署复用。
该技能通过"创建 → 测试 → 评估 → 改进 → 重复迭代"的循环流程,将 Skill 的创建过程从"手工编写 Markdown"升级为"可测试、可衡量、可迭代改进的工程化流程"。
触发场景: 用户表达"创建技能"、“优化 Skill 描述”、“评估技能效果”、“改进现有技能”、“打包技能”等意图时自动激活。
二、项目文件结构
|
|
各目录说明:
-
agents/:用于存放特定子代理指令。定义了三个子代理:事后分析代理、盲比较代理和评分代理;当 Claude 需要进行评估、对比、分析时,会读取这些文件来获得专业指导。 -
assets/:存放模板文件、图标、字体等静态资源。 -
eval-viewer/: 可视化工具。面向人类用户的可视化窗口,将枯燥的 JSON 评测数据转化为直观的网页界面,让用户可以方便地查看输出、对比结果、留下反馈。 -
references/:存放按需加载的参考文档。目前仅有一个文件schemas.md,它定义了 skill-creator 中所有 JSON 数据结构的 Schema。 -
scripts/:存放可执行的脚本代码。所有需要确定性执行(deterministic execution)的自动化任务都封装为脚本,而不是让 AI 自由发挥。脚本 功能 核心依赖 run_loop.py主循环编排器:编排"评估→改进描述→重新评估"的完整循环 run_eval.py, improve_description.py run_eval.py运行触发评估测试:检测 Skill 描述是否能被正确触发 claude -pCLIimprove_description.py调用 Claude 来自动改进 Skill 描述 claude -pCLIaggregate_benchmark.py将多次运行的评分数据聚合为统计汇总 grading.json 文件 generate_report.py从 run_loop 的输出生成可视化 HTML 报告 优化循环输出 package_skill.py将 Skill 目录打包为 .skill文件(zip 格式)quick_validate.py quick_validate.py快速校验 Skill 文件格式合规性 SKILL.md utils.py共享工具函数(解析 SKILL.md frontmatter) —
三、整体流程
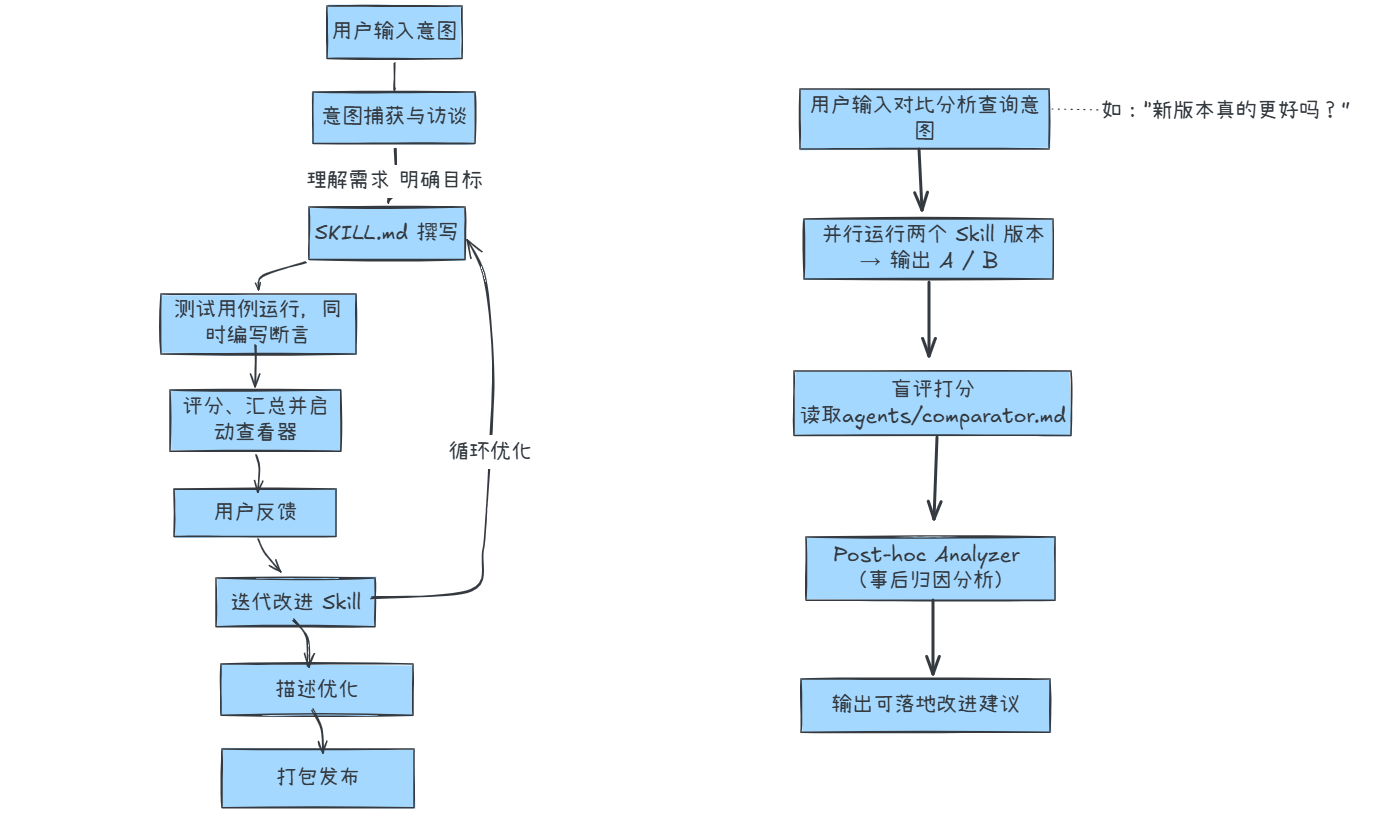
整体工作流程如下:
- 需求捕获 :从零引导用户明确意图、能力边界、触发场景、确定输出格式。
- 创建Skill :编写
SKILL.md规范(含 YAML frontmatter + 指令主体),组织目录结构,准备辅助资源;编写2-3 条测试用例。 - 运行测试: 并行启动 with_skill 和 without_skill 两组子 Agent(A/B 测试) → 利用等待时间起草量化断言 → 捕获 timing 数据 。
- 评估与集合汇总: Grader 评分 → 聚合基准数据 → Analyzer 分析 → 生成 Eval Viewer。
- 用户反馈:用户在浏览器中评审 → 收集用户反馈feedback.json。
- 迭代改进: 分析用户反馈 + 量化数据 → 重写 SKILL.md→ 新迭代运行(新
iteration-N+1/目录)→ 重复直到:用户满意 / 无新增feedback / 无明显进展。 - 盲评对比:并行运行两个 Skill 版本 → 输出 A / B → 盲评打分(读取agents/comparator.md) → Post-hoc Analyzer(事后归因分析) → 输出可落地改进建议。(当用户问如"新版本真的更好吗?“时执行)
- 优化描述: 生成触发评估查询( 生成 20 条 should-trigger + should-not-trigger)→ 用户审核(增删、修正) → 运行优化循环(python -m scripts.run_loop,迭代上限5轮:数据集拆分60% 训练集 / 40% 测试集→并行评估 → 失败归因 → 生成新 description) → 从JSON输出中获取
best_description并更新技能描述。 - 打包发布: 调用 scripts.package_skill 打包 → 输出 .skill 文件。
四、SKILL.md 结构概览
SKILL.md 是 Skill 的唯一必需文件,是理解 Skill 设计的最佳范本。
|
|
五、核心工作流详细
1、工作流一:从零创建 Skill
|
|
其中第3步编Skill 编写指南,遵循Skill 的标准目录结构及渐进式披露(Progressive Disclosure)原则:
|
|
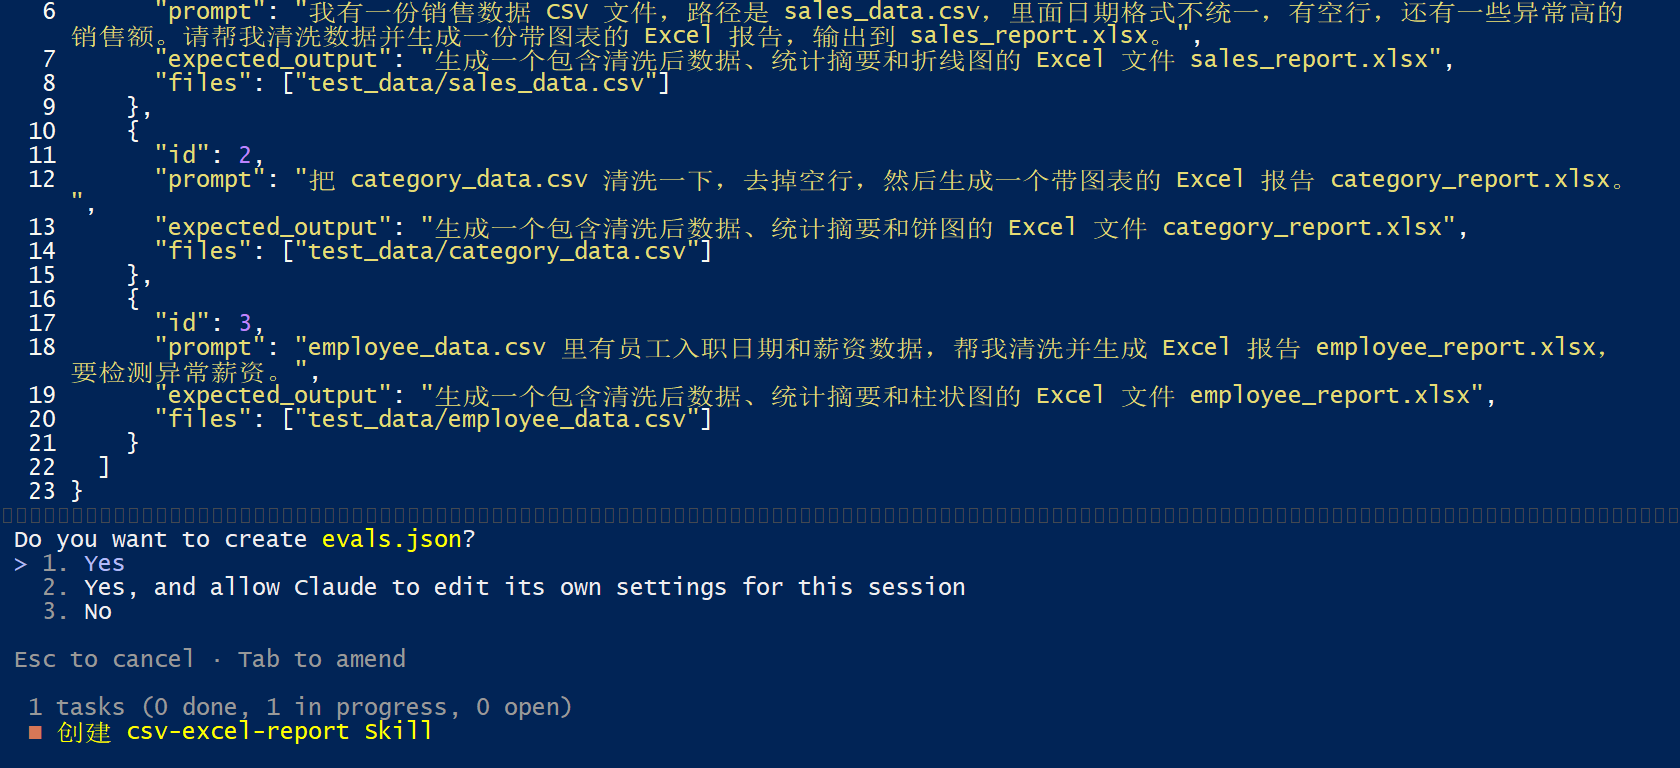
写完技能草稿后,会设计 2–3 个真实业务场景的测试用例,并保存到技能目录下的 evals/evals.json 文件中。
暂不编写断言,断言将在下一步运行测试的过程中编写。
断言用于校验技能运行结果是否符合预期,如同软件开发中的编写测试校验规则。
evals.json格式如下:
|
|
2、工作流二:运行和评估测试(Eval-Iterate Loop)
这是 skill-creator 的核心引擎,所有测试、评分、反馈均在此闭环内完成,共5个步骤:
Step 1:并行启动所有测试运行
对于每个测试用例,在同一轮中同时启动两个子代理(subagent):
- with_skill:加载了 Skill 的子代理执行任务.
- baseline(基线):没有使用Skill 的子代理执行同样的任务.
同时启动所有任务,这样它们会大致同时完成,避免等待偏差。
Step 2: 运行测试时,并行起草断言
在子代理运行期间(后台),skill-creator 不空闲,而是:
- 为每个测试用例编写可验证的 assertions。
- 断言编写完成后,更新
eval_metadata.json文件和evals/evals.json。 - 向用户解释评估标准。
断言就是可以客观验证的检查项,例如"输出文件是否包含某个关键字段”。
evals.json 更新后示例如下:
|
|
Step 3: 实时捕获性能数据
子代理完成时,通知中包含 total_tokens 和 duration_ms,需立即保存到 timing.json,后续用于统计分析:
|
|
⚠️ 关键机制:该数据仅通过任务通知传递一次,不持久化,错过无法恢复。
Step 4: 评分、聚合基准汇总、可视化
-
对每个运行评分——启动评分代理(读取 agents/grader.md)根据测试输出评估每个断言,给每个断言打分,将结果保存到每个运行目录中的
grading.json。grading.json的expectations数组必须使用text、passed和evidence字段。grading.json示例:1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21{ "expectations": [ { "text": "输出包含姓名'John Smith'", "passed": true, "evidence": "在执行记录第3步发现:'提取的姓名:John Smith, Sarah Johnson'" } ], "summary": {"passed": 2, "failed": 1, "total": 3, "pass_rate": 0.67}, "execution_metrics": {...}, "timing": {"executor_duration_seconds": 165.0,...}, "claims": [...], "eval_feedback": { "suggestions": [ { "assertion": "输出包含姓名'John Smith'", "reason": "一个幻觉文档提到这个名字也会通过——建议检查它是否作为主要联系人出现" } ] } } -
汇总到基准(Benchmark )——从skill-creator目录运行聚合脚本:
1python -m scripts.aggregate_benchmark <workspace>/iteration-N --skill-name <name>这会读取并聚合评分数据(grading.json),生成
benchmark.json和benchmark.md,包含每个配置的通过率、时间和令牌使用情况,以及统计均值(mean)、标准差(stddev)和差值(Delta )。benchmark.json格式示例如下:1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37{ "metadata": { "skill_name": "pdf", "skill_path": "/path/to/pdf", ... }, "runs": [ { "eval_id": 1, "eval_name": "Ocean", "configuration": "with_skill", "run_number": 1, "result": {"pass_rate":0.85,"passed":6,"failed":1,"total":7,"time_seconds":42.5,"tokens":3800,"tool_calls":18,"errors":0}, "expectations": [{"text":"...","passed":true,"evidence":"..."}], "notes": ["使用2023年数据,或已过时","非可填字段采用文本叠加处理"] } ], "run_summary": { "with_skill": { "pass_rate": {"mean":0.85,"stddev":0.05,"min":0.80,"max":0.90}, "time_seconds": {"mean":45.0,"stddev":12.0,"min":32.0,"max":58.0}, "tokens": {"mean":3800,"stddev":400,"min":3200,"max":4100} }, "without_skill": { "pass_rate": {"mean":0.35,"stddev":0.08,"min":0.28,"max":0.45}, "time_seconds": {"mean":32.0,"stddev":8.0,"min":24.0,"max":42.0}, "tokens": {"mean":2100,"stddev":300,"min":1800,"max":2500} }, "delta": {"pass_rate":"+0.50","time_seconds":"+13.0","tokens":"+1700"} }, "notes": [ "「输出为PDF文件」校验项全量通过,无法体现技能差异", "测试用例3波动大,运行不稳定或受模型影响", "未启用技能时,表格提取校验均失败", "技能平均耗时增加13秒,通过率提升50%" ] } -
分析——
Analyzer Agent阅读基准数据,找出汇总统计数据可能隐藏的模式。读取agents/analyzer.md(“分析基准结果"部分),了解分析的准则。 -
启动查看器,执行
eval-viewer/generate_review.py,同时显示定性输出和定量数据,HTML 交互界面(Outputs + Benchmark 双标签)。告知用户:“我已经在你的浏览器中打开了结果。有两个选项卡——‘输出’让你可以点击查看每个测试用例并留下反馈,
基准显示定量比较。完成后回到这里告诉我。”
Step 5: 人工审查并反馈
用户通过浏览器查看:
- Outputs 标签:逐条查看测试用例输出,对比前一次迭代。
- Benchmark 标签:查看通过率、耗时、token 消耗的统计对比。
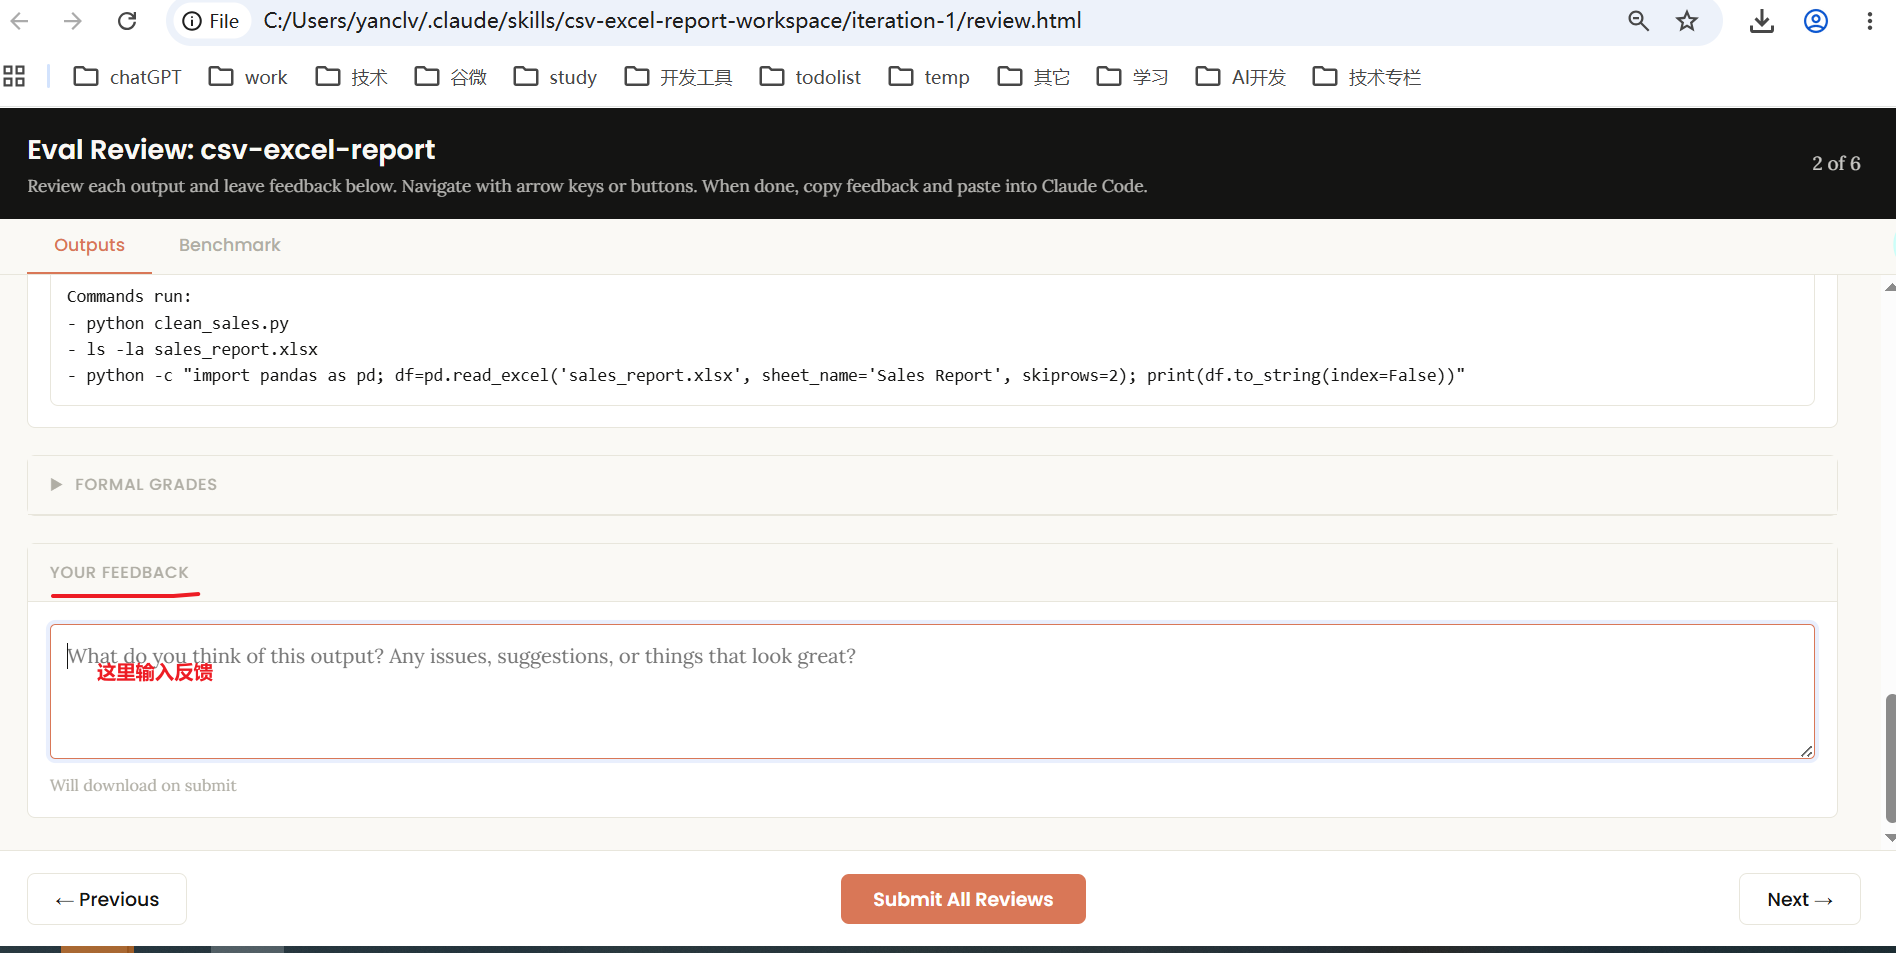
在 feedback 文本框中输入改进意见,点击"提交所有评论”,反馈保存为 feedback.json。空反馈意味着用户认为没问题。
feedback.json内容示例:
|
|
3、工作流三:迭代改进技能
Step 1: 改进技能
本环节是整个流程的核心闭环。你已经运行了测试用例,用户已经审核了结果,现在需要根据用户的反馈(feedback.json)改进技能,遵循 4 条改进原则:
-
原则1—Generalize(从反馈中泛化,而非过拟合):
we’re trying to create skills that can be used a million times across many different prompts
从具体反馈抽象出通用模式,避免过拟合。目标不是让技能在这三五个测试用例上表现完美,而是要提炼出能扛住百万次不同提示的通用模式。如果某个问题反复出现,不要堆砌越来越多的
MUST/NEVER硬规则去"堵漏洞"——这会让技能越来越僵化。更好的做法是尝试扩展思路,使用不同的隐喻,或者推荐不同的工作模式。 -
原则2—Keep lean(保持精简,移除无效指令):
Remove things that aren’t pulling their weight
阅读测试的完整执行过程(transcript),识别浪费时间的行为。如果看起来技能让模型浪费了大量时间做无效率的事情,尝试删除技能中导致这种情况的指令。
-
原则 3 — Explain the why(解释"为什么"):
现代大模型有很强的心理理论和推理能力。解释"为什么"比命令"做什么"更有效。如果发现自己要写
ALWAYS或NEVER,或者设计极其死板的结构,这是一个黄色警告——如果可能的话,重新表述并解释原因,让模型理解你要求的事情为什么重要,这是一种更人性化、更强大、更有效的方法。 -
原则 4 — Bundle repeated work(整合重复工作):
如果发现多个子代理都在写同一个辅助脚本(比如
create_docx.py、build_chart.py),这就是强烈的信号:这个公共逻辑应该被提取出来,作为技能自带的工具脚本,放在scripts/目录下。
Step 2: 迭代循环
改进技能后:
- 应用改进到技能上。
- 在新的
iteration-<N+1>/目录中重新运行所有测试用例,包括基线运行:如果你创建新技能,基线始终是without_skill(不使用技能);如果正在改进现有技能,根据你的判断选择合适的基线:用户提供的原始版本,或上一次迭代的版本。 - 继续直到:
- 用户说他们满意。
- 所有反馈都是空的(一切看起来都很好)。
- 你没有取得有意义的进展。
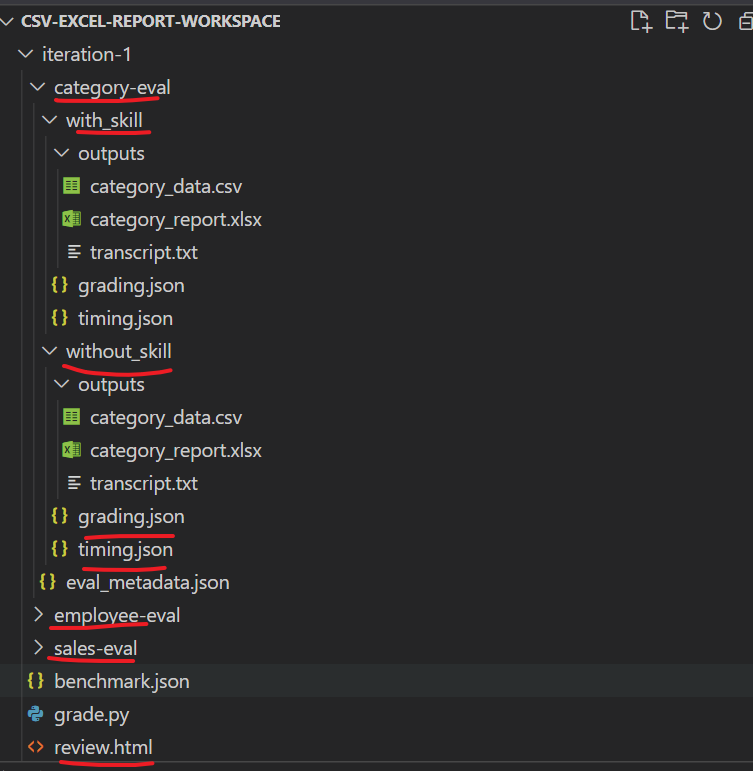
每次迭代的工作区按以下结构组织:
|
|
3、工作流四:描述优化(Trigger Optimization)
描述优化是专门针对 Skill 的触发准确率进行调优,解决:如何让 Skill 的 description 字段更精准地触发?
|
|
优化流程分四步:
-
生成评估查询:创建 20 条测试查询(约一半应该触发、一半不应该触发),要求查询尽量真实、具体、覆盖各种边缘情况。
创建20个测试查询,保存为JSON:
1 2 3 4[ {"query": "用户提示词", "should_trigger": true}, {"query": "另一个提示词", "should_trigger": false} ] -
用户审核:通过 HTML 页面(assets/eval_review.html)让用户审核和修改查询集。
-
运行优化循环:通过
scripts/run_loop.py自动执行"评估→改进→重新评估"循环。按60% train / 40% test 分割查询集,每条查询运行 3 次计算可靠触发率,最多5 次迭代。 -
应用最佳结果:取测试集上得分最高的描述(而非训练集,以避免过拟合)
注意:Skills 的触发机制是 Claude 基于 available_skills 列表中的 name + description 做意图匹配。简单查询(如"读取 PDF")可能不会触发 Skill,因为 Claude 可直接用基础工具处理;复杂、多步骤、专业化查询才会可靠触发。
关于触发机制的注意事项:
Claude only consults skills for tasks it can’t easily handle on its own
Claude 只会在遇到自己不容易处理的复杂任务时才会去"查阅" Skill。简单查询(如"读取 PDF")可能不会触发 Skill,因为 Claude 可直接用基础工具处理。因此,评估查询需要足够具体、多步骤、专业化。
4、工作流五:盲比较
|
|
执行细节:
-
comparator 严格不知晓A/B 对应哪个 Skill,仅依据 rubric(Content + Structure,各 1-5 分)和 assertions 裁决。
双维度评分体系(综合为 1-10 的总分):
- Content (内容维度):正确性、完整性、准确性(各 1-5 分)
- Structure(结构维度):组织性、格式化、可用性(各 1-5 分)
-
analyzer 在 Comparator 完成评分后进行“揭盲”,读取双方 SKILL.md 文档、运行记录(transcripts)等数据,深入分析差异点,最终生成按 priority(优先级)+ category(类别)组织的可落地改进建议,明确优化方向。
核心原则:在完全不知道哪个输出来自哪个 Skill 的前提下,判断两者优劣。
六、核心机制解析
1、Progressive Disclosure(渐进式披露)
skill-creator 自身就是 Progressive Disclosure 架构的最佳实践:
|
|
工程意义:
-
即使安装 50 个 Skill,启动时仅加载 50 × ~100 tokens = 5000 tokens 的元数据。
-
避免上下文窗口被不相关技能挤占,保障主任务可用 token 空间。
2、总体哲学
SKILL.md 开篇以通俗语言介绍了 skill-creator的核心工作流程:
At a high level, the process of creating a skill goes like this:
- Decide what you want the skill to do and roughly how it should do it
- Write a draft of the skill
- Create a few test prompts and run claude-with-access-to-the-skill on them
- Help the user evaluate the results both qualitatively and quantitatively
- Rewrite the skill based on feedback
- Repeat until you’re satisfied
- Expand the test set and try again at larger scale
解读:该流程类似文稿打磨,先出初稿、然后请人看看,结合反馈修改,迭代直到满意;不同之处在于本流程搭配自动化工具完成评测与对比。
安全原则(Principle of Lack of Surprise):
“skills must not contain malware, exploit code, or any content that could compromise system security”
(Skill 的内容不应该让用户感到意外——它做的事情应该与描述一致,不能包含恶意代码。)
3、沟通风格指南(人性化设计的典范)
skill-creator 开篇就强调了一个非常现实的问题:
“there’s a trend now where the power of Claude is inspiring plumbers to open up their terminals, parents and grandparents to google ‘how to install npm’”
(如今出现了一个有趣的现象:得益于 Claude 强大的能力,水管工开始尝试使用命令行,父母和长辈也主动上网搜索 “如何安装 npm”。)
核心要点:
evaluation和benchmark属于"边界词汇"——可以直接用,但最好确认用户理解。JSON和assertion属于"技术词汇"——必须先确认用户懂这些术语,或附上简短解释。
设计价值:这教会我们在设计 Skill 时,要考虑目标用户的多样性,而不是假设所有人都是技术专家。
4、多代理协作架构
skill-creator使用子代理(subagent )能力,实现隔离上下文、并行化执行。主要包含四个子代理:
-
Executor (执行代理)
对于每个测试用例,在同一轮中生成两个子代理——一个使用该技能,一个不使用。同时启动所有任务,这样它们会大致同时完成。
1 2 3 4 5 6执行此任务: - 技能路径:<path-to-skill> - 任务:<eval prompt> - 输入文件:<eval files if any, or "none"> - 保存输出到:<workspace>/iteration-<N>/eval-<ID>/with_skill/outputs/ - 要保存的输出:<用户关心的内容——例如,"docx文件"、"最终CSV">基线运行(相同的提示词,但基线取决于上下文),分两种情况:
- 创建新技能:完全不使用技能。相同的提示词,没有技能路径,保存到
without_skill/outputs/。 - 改进现有技能:使用旧版本。编辑前,快照技能(
cp -r <skill-path> <workspace>/skill-snapshot/),然后将基线子代理指向快照。保存到old_skill/outputs/。
- 创建新技能:完全不使用技能。相同的提示词,没有技能路径,保存到
-
Grader Agent (评分代理)
对每个运行评分,读取
agents/grader.md根据输出评估每个断言。将结果保存到每个运行目录中的grading.json。职责:评审执行结果,判断每个"断言"(assertion)是通过还是失败,并为每项判断提供清晰的证据。
输入:
expectations:要检查的断言列表(如"输出包含姓名’John Smith’")transcript_path:执行过程的完整记录outputs_dir:输出文件目录
工作流程(8步):
- 读取Transcript(执行记录)。
- 检查输出文件。
- 逐一评估断言(判定结果:PASS/FAIL、引用证据)。
- 提取并验证隐含声明
- 阅读用户备注(若
{outputs_dir}/user_notes.md存在) - 批判性审视评测本身(这是亮点!)
- 撰写评分结果 ,写入
grading.json - 读取执行指标和计时数据,输出结构的 JSON 文件(结果保存到
{outputs_dir}/../grading.json)。
“关键设计—自我批评:
“A passing grade on a weak assertion is worse than useless — it creates false confidence. When you notice an assertion that’s trivially satisfied, or an important outcome that no assertion checks, say so..”
对薄弱断言给出"通过"的评级,其危害比毫无用处还要糟糕——它制造虚假信心。当你注意到某个断言被轻易满足,或某个重要结果没有任何断言检查时,请指出来。
Grader 不仅评分,还会指出评测设计的问题:
- “这个断言太弱,即使输出明显错误也会通过”
- “有个重要结果没有任何断言覆盖”
输出格式(grading.json):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21{ "expectations": [ { "text": "输出包含姓名'John Smith'", "passed": true, "evidence": "在执行记录第3步发现:'提取的姓名:John Smith, Sarah Johnson'" } ], "summary": {"passed": 2, "failed": 1, "total": 3, "pass_rate": 0.67}, "execution_metrics": {...}, "timing": {...}, "claims": [...], "eval_feedback": { "suggestions": [ { "assertion": "输出包含姓名'John Smith'", "reason": "一个幻觉文档提到这个名字也会通过——建议检查它是否作为主要联系人出现" } ] } } -
Comparator Agent (盲评对比代理)
对于严格比较两个版本技能的情况(例如,用户问"新版本真的更好吗?"),读
agents/comparator.md和agents/analyzer.md。基本思路:将两个输出交给独立代理,不告诉它哪个技能产生哪个输出,让它判断质量;然后分析获胜者获胜的原因。**角色:**盲测比较器,负责在不知道哪个技能产生哪个输出的情况下,判断哪个输出更好。目的是防止对特定技能或方法产生偏见。
工作流程:
- 读取输出 A 和输出 B(只知道代号,不知道对应哪个 Skill)
- 理解任务要求.
- 生成评分量表(Rubric),双维度评分体系(综合为 1-10 的总分):
- Content(内容维度):Correctness(正确性)、Completeness(完整性)、Accuracy(准确性)
- Structure(结构维度):Organization(组织性)、Formatting(格式)、Usability(可用性)
- 按量表评分(1-5分制)
- 检查断言通过率(辅助证据)
- 判定胜者(A、B 或平局)
输出格式(comparison.json):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25{ "winner": "A", "reasoning": "输出A提供了完整解决方案...", "rubric": { "A": {"content_score": 4.7, "structure_score": 4.3, "overall_score": 9.0}, "B": {"content_score": 2.7, "structure_score": 2.7, "overall_score": 5.4} }, "output_quality": { "A": { "score": 9, "strengths": ["Complete solution", "Well-formatted", "All fields present"], "weaknesses": ["Minor style inconsistency in header"] },... }, "expectation_results": { "A": { "passed": 4, "total": 5, "pass_rate": 0.80, "details": [ {"text": "Output includes name", "passed": true} ] },... } } -
Analyzer Agent(分析子代理)
包含两大角色:
角色 A — 盲测后分析器:在盲测比较后"揭盲”,目标是提取可操作的洞察:是什么让获胜方表现更好,以及如何改进落败方?
-
对比两个 Skill 的指令差异和执行模式差异。
-
最终生成按 priority(优先级:high / medium / low)+ category(类别:instructions、tools、examples、error_handling、structure、references)组织的可落地改进建议,明确优化方向。
改进建议分类:
类别 说明 instructions修改 Skill 的文本指令 tools添加/修改脚本、模板 examples添加示例输入/输出 error_handling添加失败处理指南 structure重组 Skill 内容 references添加外部文档 输出
analysis.json格式示例如下:1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41{ "comparison_summary": { "winner": "A", "winner_skill": "path/to/winner/skill", "loser_skill": "path/to/loser/skill", "comparator_reasoning": "选择优胜方的简要原因" }, "winner_strengths": [ "针对多页文档提供清晰分步指引", "内置校验脚本,可识别格式错误" ], "loser_weaknesses": [ "指令表述模糊,执行结果不一致", "无校验脚本,只能临时应对" ], "instruction_following": { "winner": { "score": 9, "issues": ["小问题:省略可选日志步骤"] }, "loser": { "score": 6, "issues": [ "未使用指定格式模板", "未按第三步要求,自行改用其他方式" ] } }, "improvement_suggestions": [ { "priority": "high", "category": "instructions", "suggestion": "将模糊指令改为明确操作步骤", "expected_impact": "消除歧义,统一执行效果" } ], "transcript_insights": { "winner_execution_pattern": "读取技能 → 按五步流程执行 → 调用校验脚本", "loser_execution_pattern": "读取技能 → 思路不明确 → 尝试多种方式" } }
角色 B — 基准分析器:在测试评估后,分析基准测试结果,基准分析器的目的不是提出技能改进建议,而是揭示多次运行中的模式和异常:
-
哪些断言在两种配置下始终(100%)通过吗?(可能无法区分技能价值)。
-
哪些断言在两种配置下始终(100%)失败吗?(可能已损坏或超出能力范围)。
-
是否有技能时始终通过,无技能时始终失败?(技能在此处明显增加了价值)。
-
是否有技能时始终失败,无技能时始终通过?(技能可能正在造成损害)。
-
是否高度不稳定?(不稳定的预期或非确定性行为)。
输出格式为 JSON 字符串数组:
1 2 3 4 5 6[ "断言‘输出是 PDF 文件’在两种配置下 100% 通过——可能无法区分技能价值", "评估 3 显示高方差(50% ± 40%)——运行 2 出现了异常失败", "无技能运行始终在表格提取预期上失败", "技能平均增加 13 秒执行时间,但将通过率提高了 50%" ] -
5、盲测比较的方法论
agents/comparator.md 和 agents/analyzer.md 构成了一套因果推断框架:
- Comparator(盲测):消除"先入为主"和"作者偏见"。输出必须包含
rubric(量化评分)+output_quality(定性总结)+expectation_results(断言通过率)。 - Analyzer(归因):揭盲后执行反事实分析。对比双方执行记录(transcripts),检查 instruction following 得分(1-10),识别 winner 的优势(提取可操作的洞察:是什么让获胜方表现更好)和 loser 的可改进点。
关键设计:Analyzer 的 improvement_suggestions 按 priority(high/medium/low)和 category(instructions/tools/examples/error_handling/structure/references)分类,确保建议可操作、可度量。
6、反过拟合机制
skill-creator 内置多层防过拟合设计:
-
从反馈中归纳:Skill 要在许多不同提示词中使用百万次,如果只为测试用例做针对性修改,skill 就废了。遇到顽固问题,尝试扩展思路,使用不同的隐喻,或者推荐不同的工作模式,而不是加更多死板约束。
-
Train/Test 分割:Description 优化时 60训练集/40测试集分割,选择 test 分数最高的描述。
-
Baseline 对照:每次迭代必须对比无 Skill 或 旧版本 Skill 的表现,确保改进真实有效。
-
Blind Comparison:可选的 A/B 盲评,消除评估者偏见。
7、数据流与 Schema 约束
所有评估数据遵循 references/schemas.md 的严格结构,形成完整的数据管道:
|
|
关键约束:
grading.json的 expectations 数组必须使用字段text、passed、evidence,viewer 依赖这些精确字段名。benchmark.json的 configuration 必须是"with_skill"或"without_skill"(viewer 硬编码匹配)。timing.json的数据必须在子代理完成通知中实时捕获,过后不可恢复。
8、scripts/ —— 自动化脚本详解
1)run_loop.py —— 主循环编排器
职责:编排整个"描述优化"的自动化循环。
工作流程:
- 将评估查询集按 60:40 分为训练集和测试集(分层采样,保持正负样本比例)。
- 对当前描述运行评估(每条查询运行 3 次取可靠触发率)。
- 调用
improve_description.py让 Claude 改进描述。 - 对新描述重新评估
- 最多迭代 5 轮,选取测试集得分最高的描述(而非训练集,防止过拟合)
- 生成实时 HTML 报告。
run_loop.py核心代码:
|
|
关键设计——防止过拟合:
- 类似机器学习的 Train/Test 分离。
- 改进时看不到测试集结果。
- 最终选择按测试集选择最佳description而非训练集。
2)run_eval.py —— 触发评估运行器
职责: 测试 Skill 描述是否能正确触发。
核心机制:
- 在
.claude/commands/目录创建临时命令文件 - 运行
claude -p(Claude CLI)并使用--stream-json --include-partial-messages参数 - 通过流式事件检测 Claude 是否触发了该 Skill(早期检测)
- 支持通过
ProcessPoolExecutor并行执行多条查询
3)improve_description.py —— 描述自动改进
职责: 调用 Claude 来生成改进后的 Skill 描述。
核心流程:
- 分析失败案例:
- Failed triggers:应该触发但没触发(漏召)
- False triggers:不该触发但触发了(误召)
- 构建 Prompt 让 Claude 生成新描述:
- 包含当前描述
- 包含失败案例(具体查询+触发次数)
- 包含历史尝试(避免重复)
- 包含 Skill 完整内容(上下文)
- 关键约束:
- “不要产生越来越长的具体查询列表”
- “要泛化到更广泛的用户意图类别”
- “描述不超过100-200词,硬限制1024字符”
- “用祈使句,聚焦用户意图而非实现细节”
- 安全网:如果生成超过1024字符,自动调用缩短流程
Prompt 工程亮点:
|
|
4)aggregate_benchmark.py —— 基准聚合脚本
职责: 将分散的评分数据汇总为统计报告。
输出:
benchmark.json:结构化的完整基准数据benchmark.md:人类可读的 Markdown 格式报告- 计算每个配置(with_skill / without_skill)的均值、标准差、最小值、最大值
- 计算两者之间的 delta(差异)。
5)package_skill.py —— Skill 打包器
职责: 将 Skill 目录打包为可分发的 .skill 文件。
工作流程:
- 调用
quick_validate.py校验 Skill 格式。 - 创建 zip 格式的
.skill文件。 - 排除无关文件:
__pycache__、node_modules、.pyc、.DS_Store、根级evals/。
5)quick_validate.py —— Skill 格式校验
职责: 检查 Skill 是否符合规范。
校验项:
SKILL.md是否存在且包含有效的 YAML frontmatter。name字段是否为 kebab-case 格式,不超过 64 字符。description字段是否不超过 1024 字符且不含尖括号。compatibility字段(如果有)不超过 500 字符。- 只允许规定的 frontmatter 属性。
9、评测与迭代系统:evals/ 与 eval-viewer/
1) 评测数据流
|
|
2) evals.json 结构
|
|
设计要点:
prompt必须是真实用户会说的,不是抽象描述。expectations必须是客观可验证的,避免主观判断。
3) eval-viewer可视化系统
skill-creator 提供了一个完整的浏览器端评测查看器:
技术栈:
generate_review.py:Python 后端,读取评测数据并注入 HTML 模板viewer.html:纯前端 HTML(内嵌 CSS/JS),无需服务器即可运行
功能:
- Outputs 标签页:逐个查看测试用例
- 显示 Prompt、输出文件、上一轮输出(折叠)
- 正式评分结果(折叠)
- 反馈文本框(自动保存)
- 上一轮反馈(迭代时显示)
- Benchmark 标签页:统计摘要
- 通过率、时间、Token 消耗的均值±标准差
- 配置间差异(Delta)
Cowork/无浏览器环境适配:
“use
--staticto write a standalone HTML file instead of starting a server”(使用
--static参数生成独立 HTML 文件,而非启动服务器)
七、完整执行流程与数据流转
1、完整执行流程
下面是用户触发 skill-creator 到最终输出的完整流程:
|
|
2、数据流转生命周期
理解数据在各阶段之间如何流转,有助于理解整个系统的协作机制:
|
|
八、设计通用启示
-
评估即工程(Evaluation as Engineering)
skill-creator 将评估流程工程化为严格的 Schema 契约、并行实验、统计聚合和可视化审阅。好的 Skill 不是写出来的,而是测出来、比出来、迭代出来的。
-
人机协同的反馈回路
Eval Viewer 的设计体现了"人类审阅优先"的原则:Claude 不直接根据评估结果修改 Skill,而是先将 outputs 和 benchmark 呈现给用户,收集
feedback.json后再做改进。这防止了自动化系统对量化指标的过度优化。 -
盲测与因果归因的方法论
在 Skill 改进场景中,“新版本是否更好"是一个容易被偏见污染的问题。Blind Comparison 引入了一种准实验设计:匿名输出 → 量化裁决 → 结构化归因。这套方法论可直接迁移到任何 A/B 评估场景。
-
解释"为什么"而非堆砌"必须”
SKILL.md 明确反对过度使用 “ALWAYS / NEVER” 和 “super rigid structures(超刚性结构)",主张用的心智理论( theory of mind) 向模型解释为什么某个做法重要。反映了 Anthropic 对当代 LLM 能力的洞察:足够智能的模型在理解意图后,比遵循死板规则表现更好。
-
提取重复工作到脚本
如果多个 test case 都导致子代理独立写出类似的辅助脚本,这就是强烈的信号:该逻辑应被提取为 Skill 的 bundled script。这是从 prompt engineering 向软件工程过渡的关键实践。
-
泛化而非过拟合
Skill 要被使用无数次、面对无数种 prompt。如果只为测试用例做针对性修改,skill 就废了。如果某个问题反复出现,不要堆砌越来越多的
MUST/NEVER硬规则去"堵漏洞”,尝试换个隐喻或推荐不同的工作模式,而不是加更多死板约束。 -
保持提示精简
删除没有实际作用的内容——如果看起来技能让模型浪费了大量时间做无效率的事情,你可以尝试删除技能中导致这种情况的部分,看看会发生什么。
九、使用示例
场景 A:从零创建 Skill
|
|
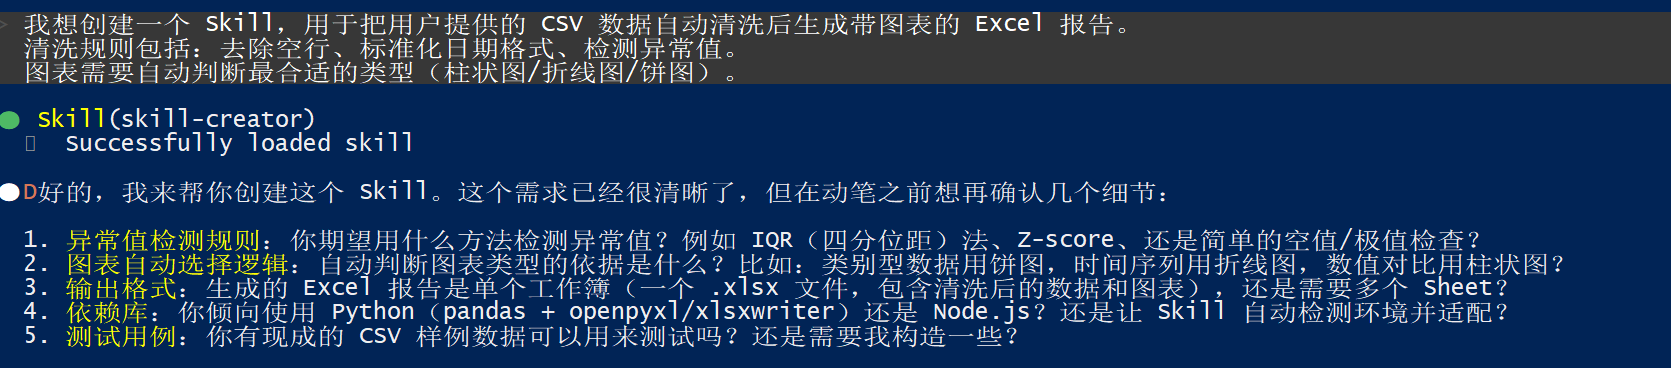
确认细节:异常值检查规则、图标选择逻辑、输出格式、依赖库、是否需要构造测试用例。
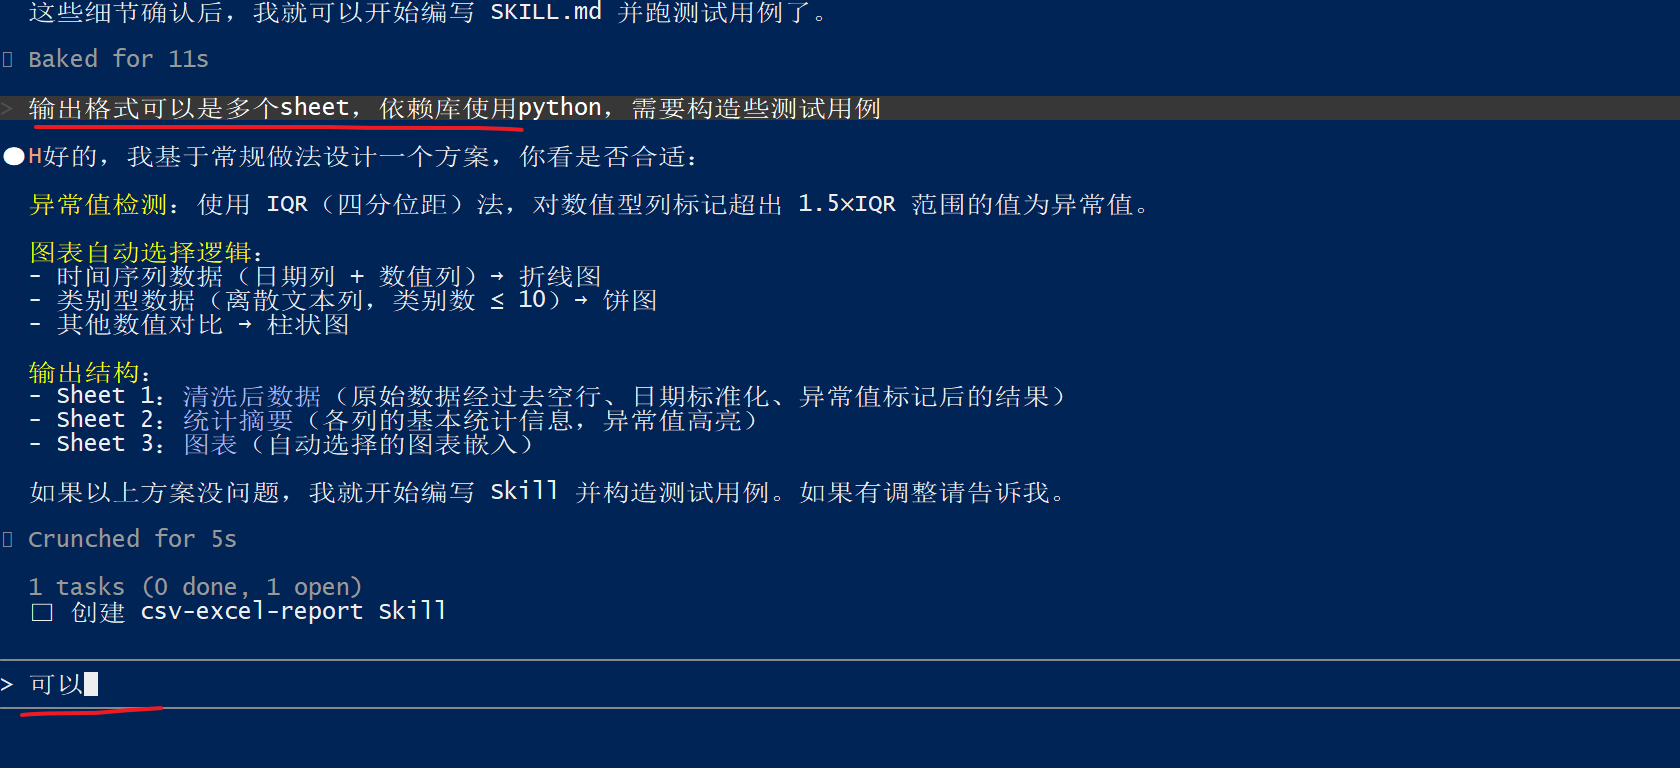
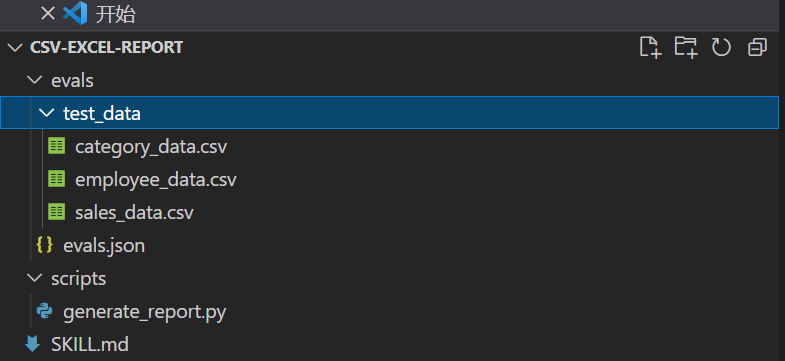
创建脚本文件
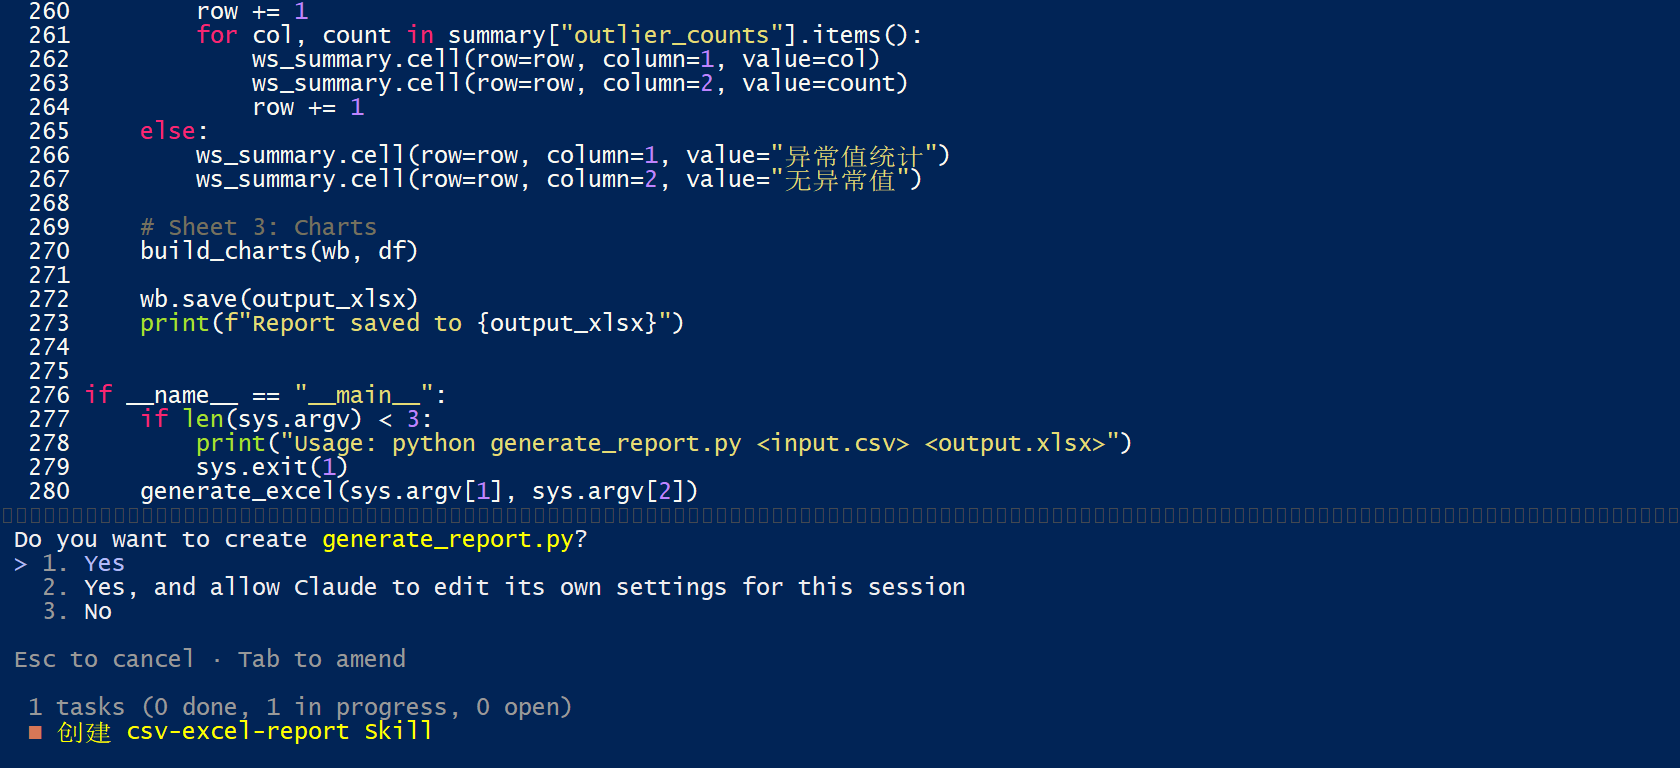
生成测试数据:
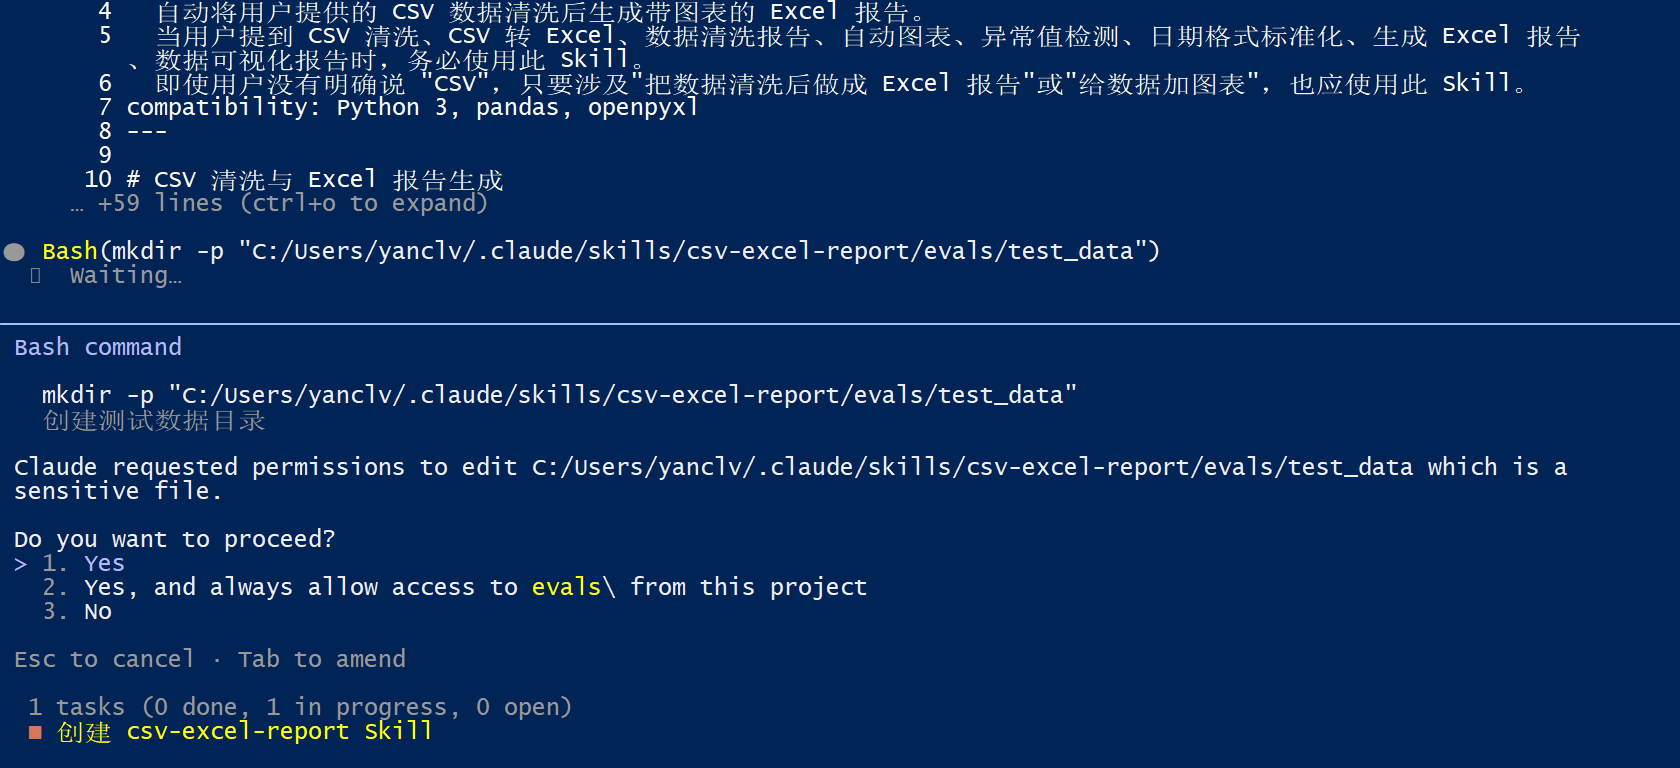
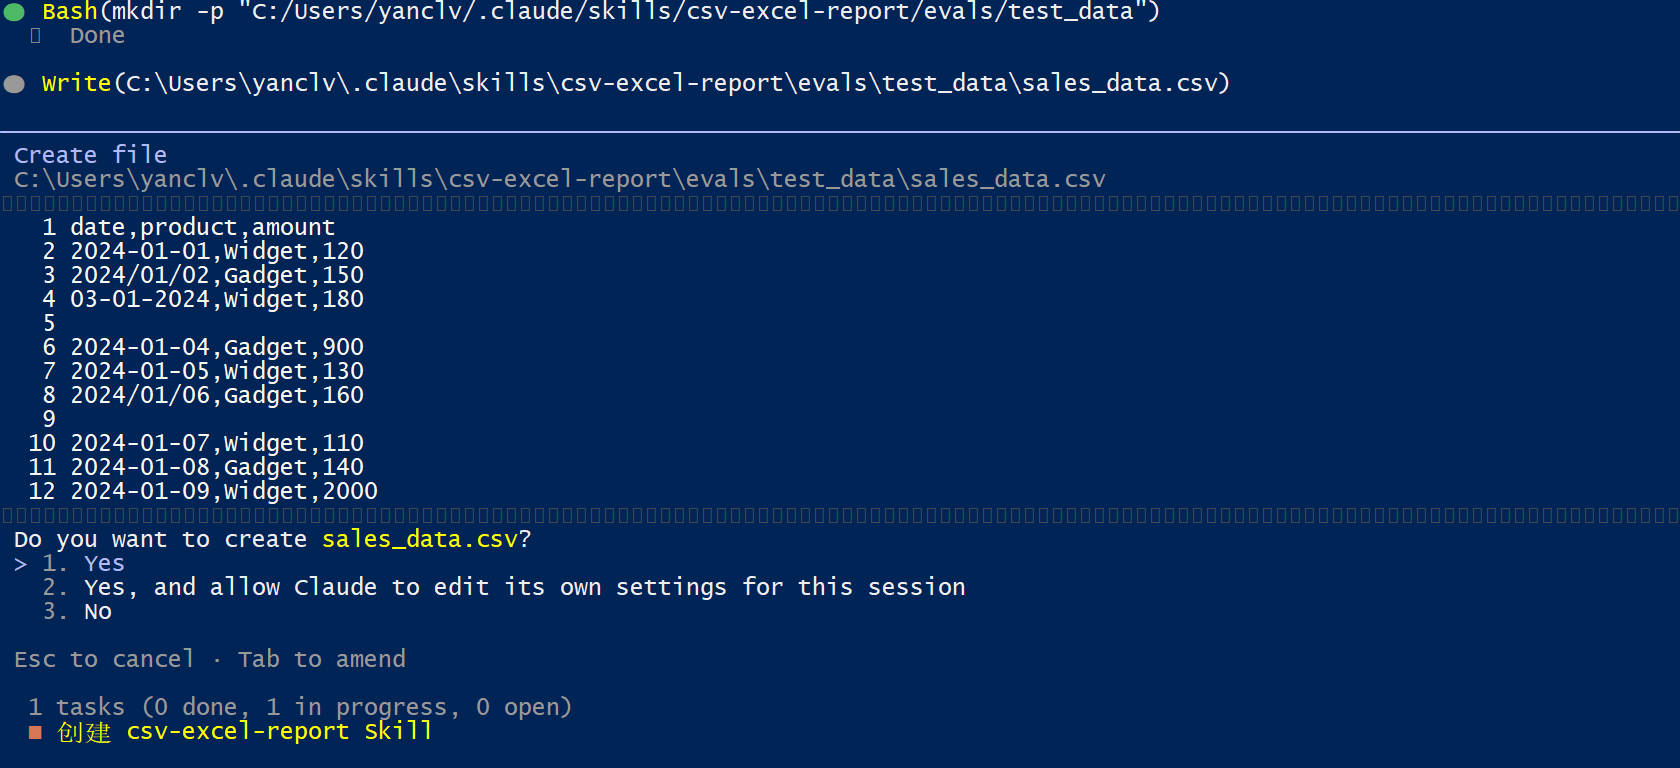
生成评估数据,保存为
evals.json。
创建测试工作目录
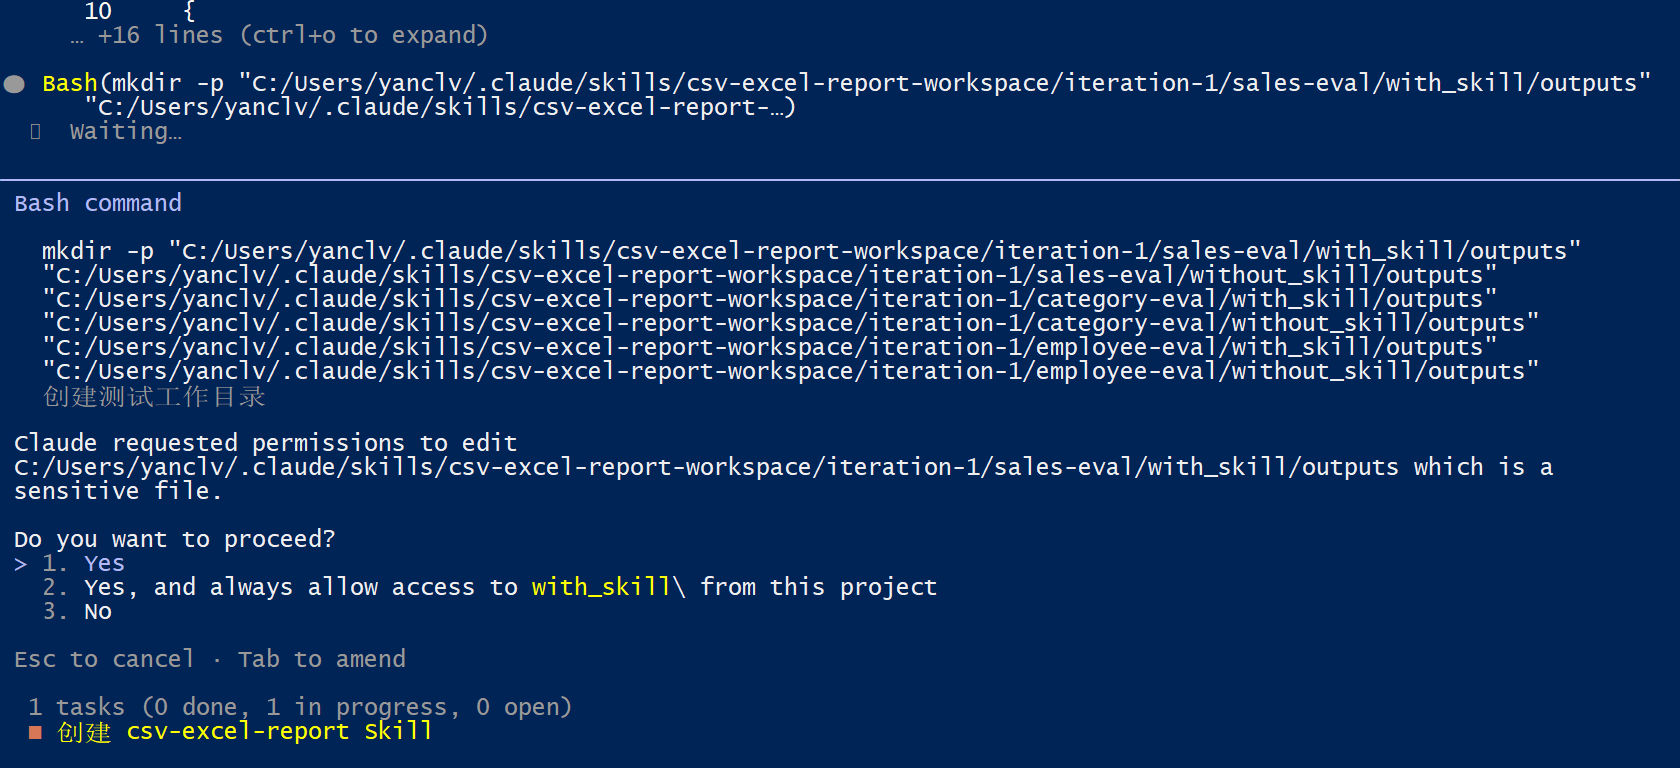
运行测试评估
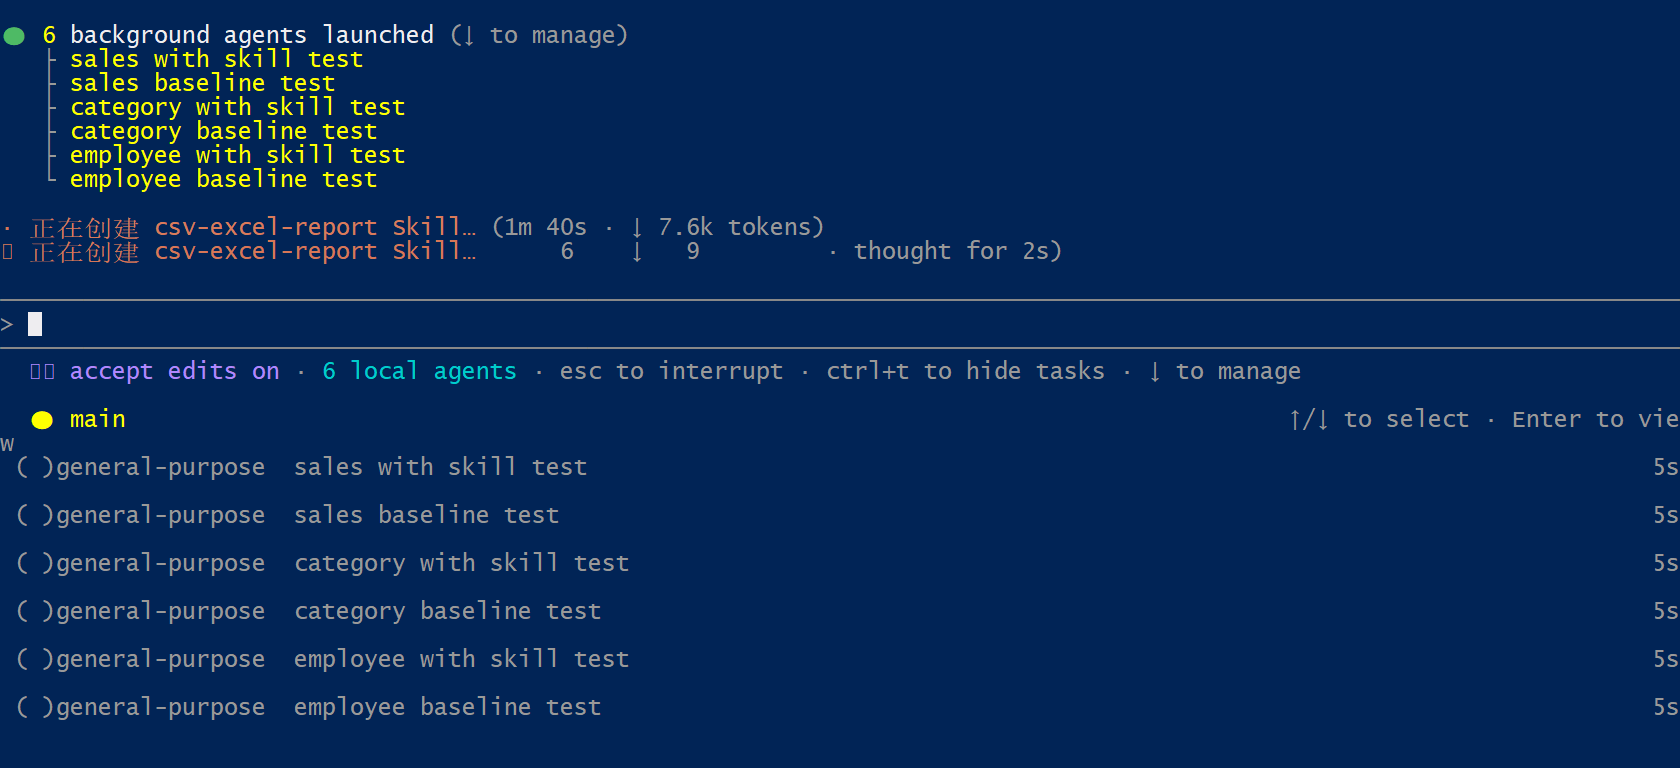
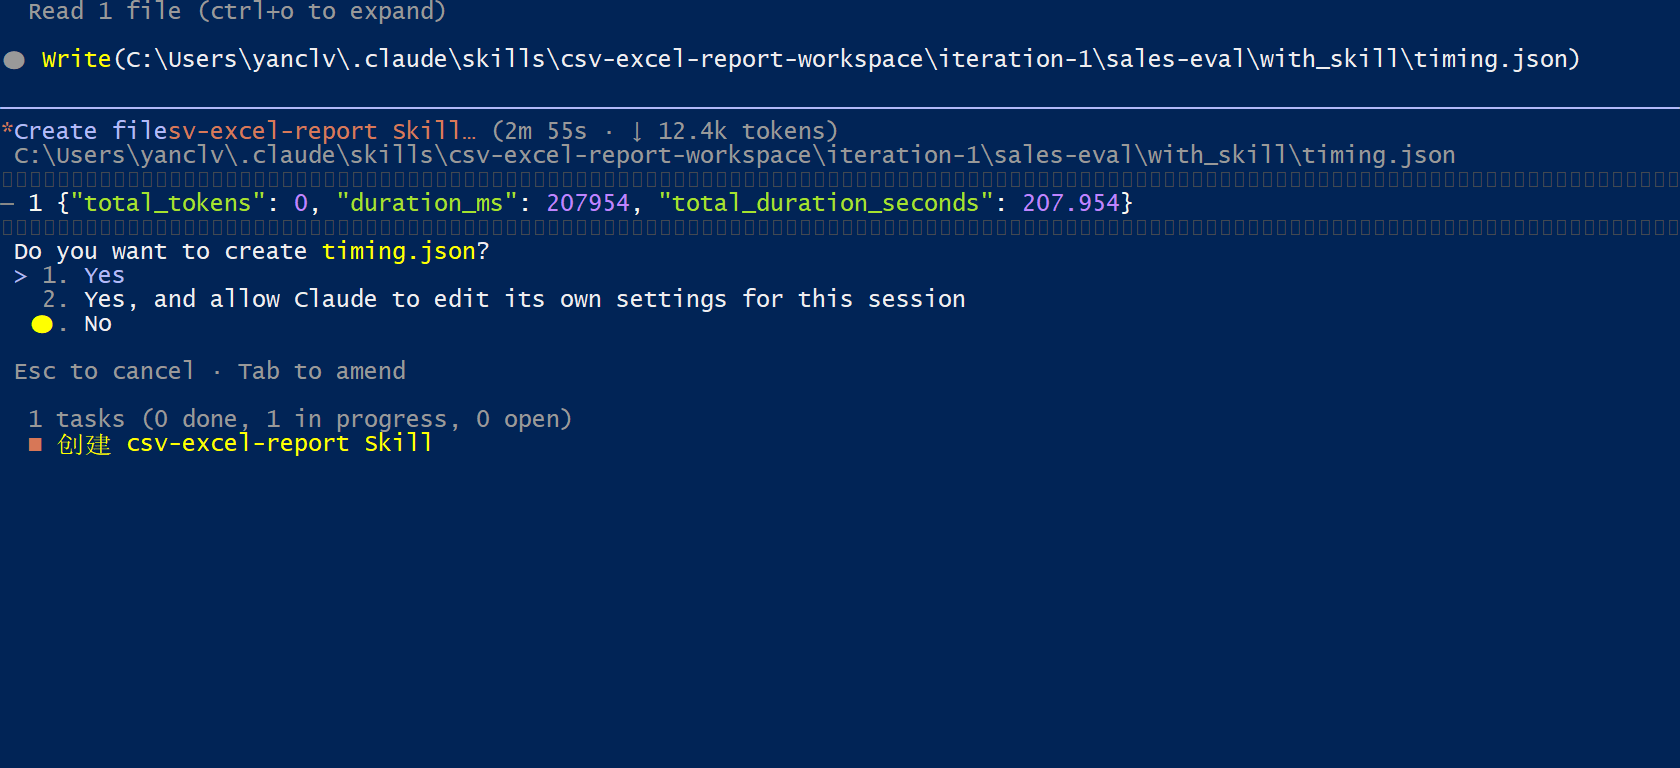
测试评估期间保存
timing.json文件
生成分析可视化报告
review.html:
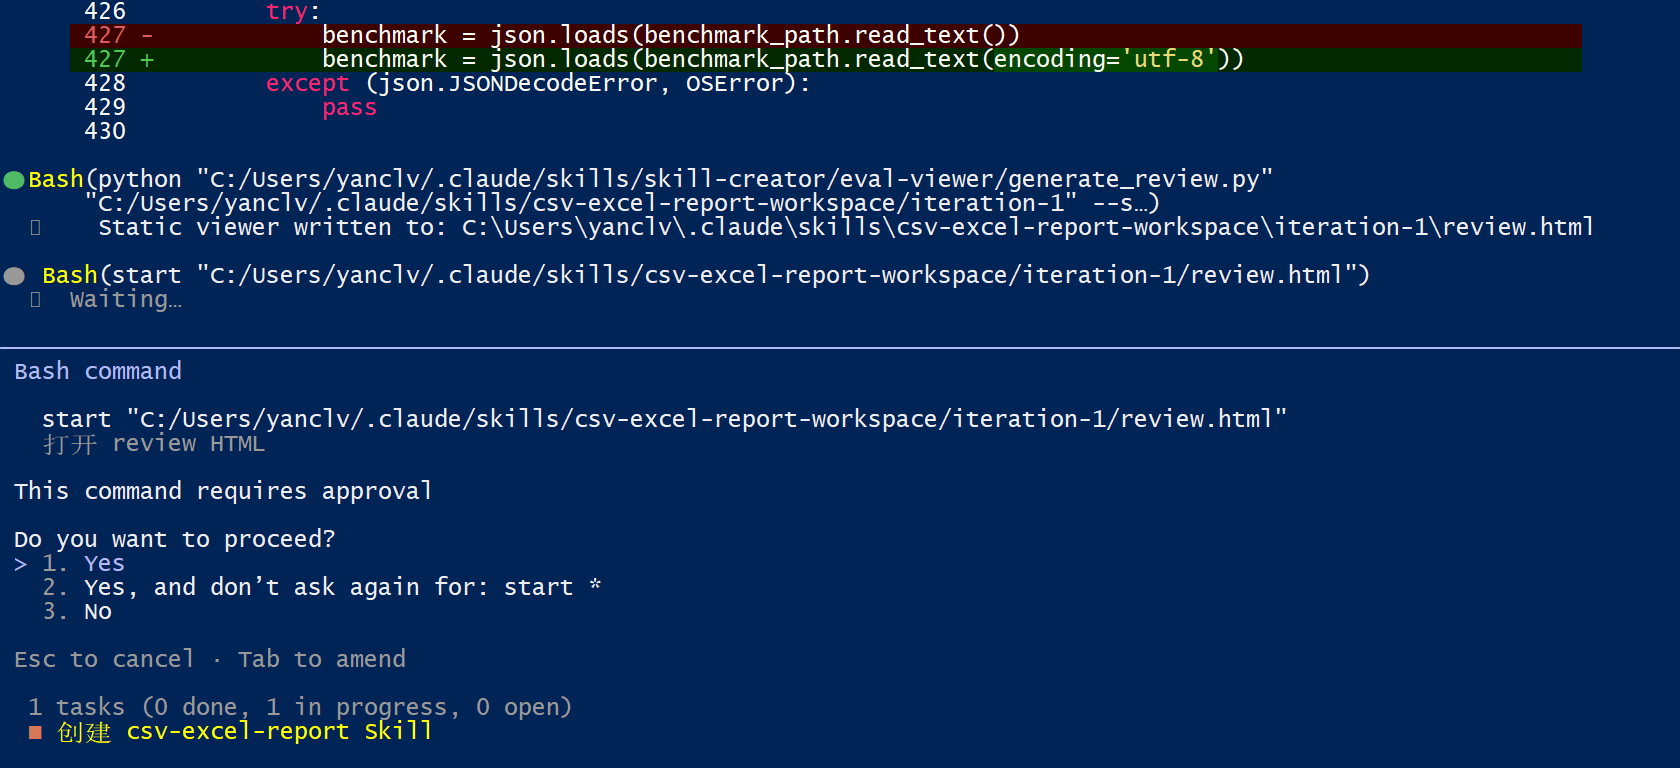
回车yes,claude 会自动调用浏览器打开review.html页面,可以看到一共6个页面,分别是:sales_data.csv、category_data.csv、employee_data.csv 三个文件的各with skill、without skill 测试报告。
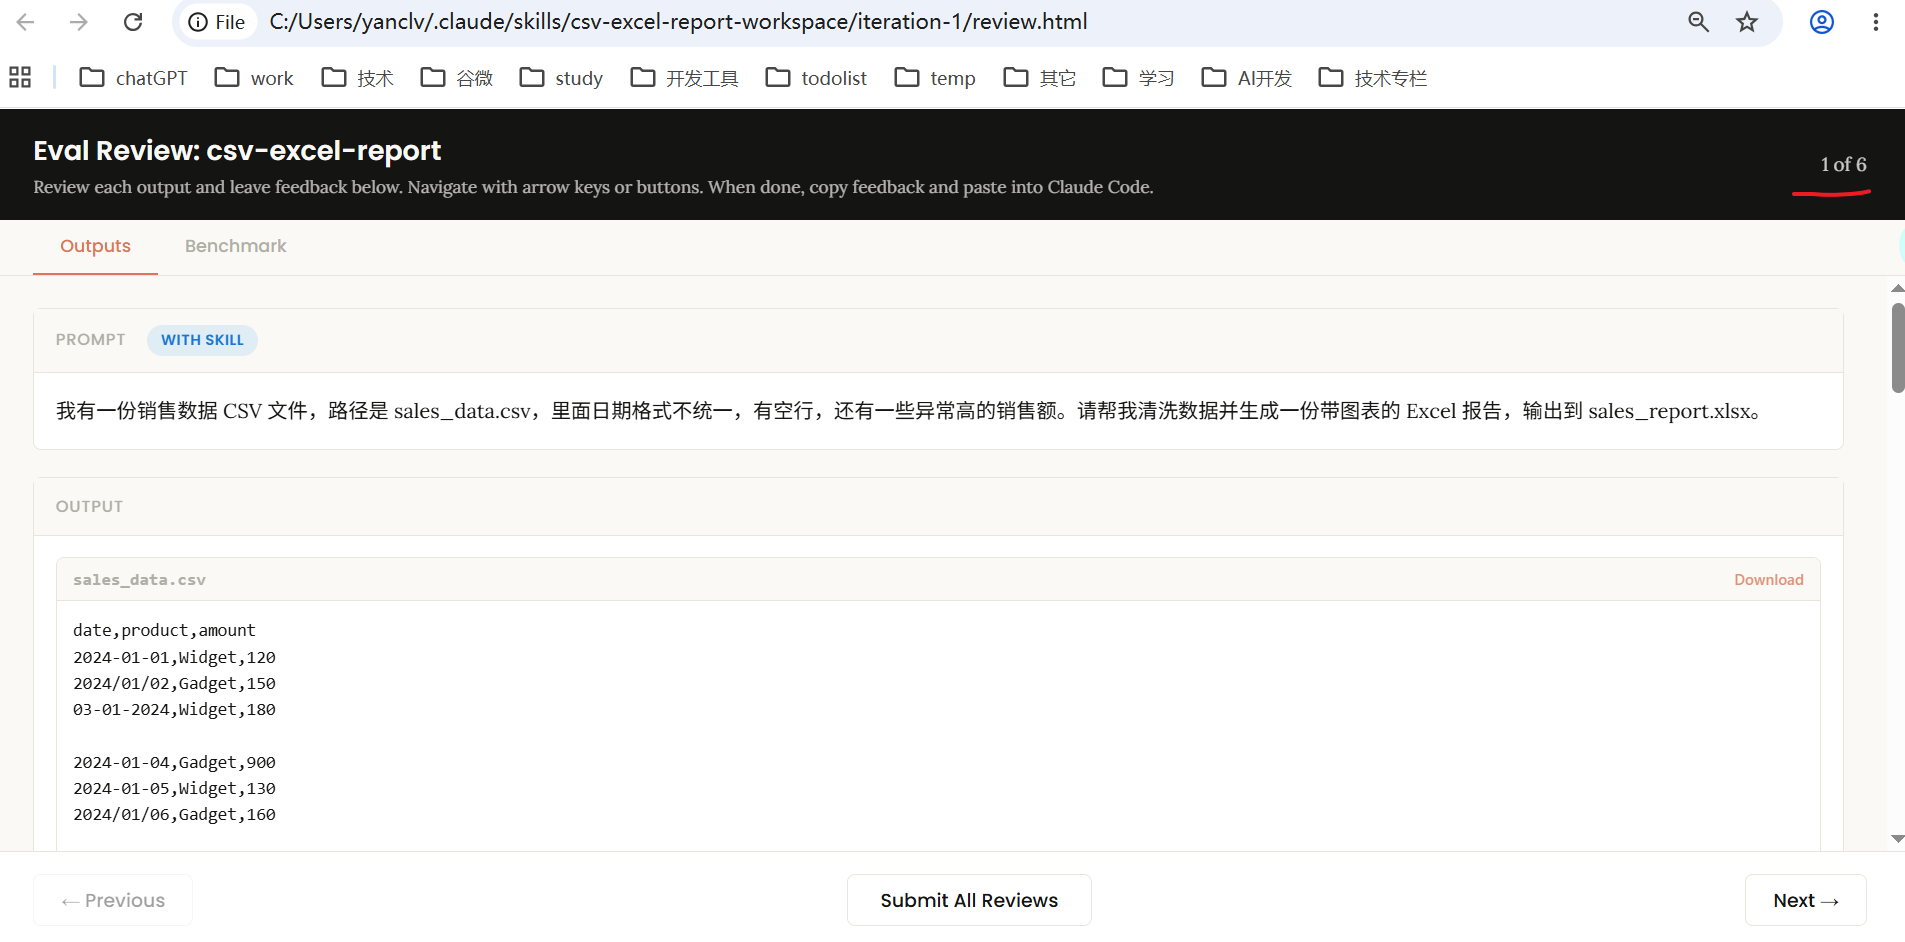
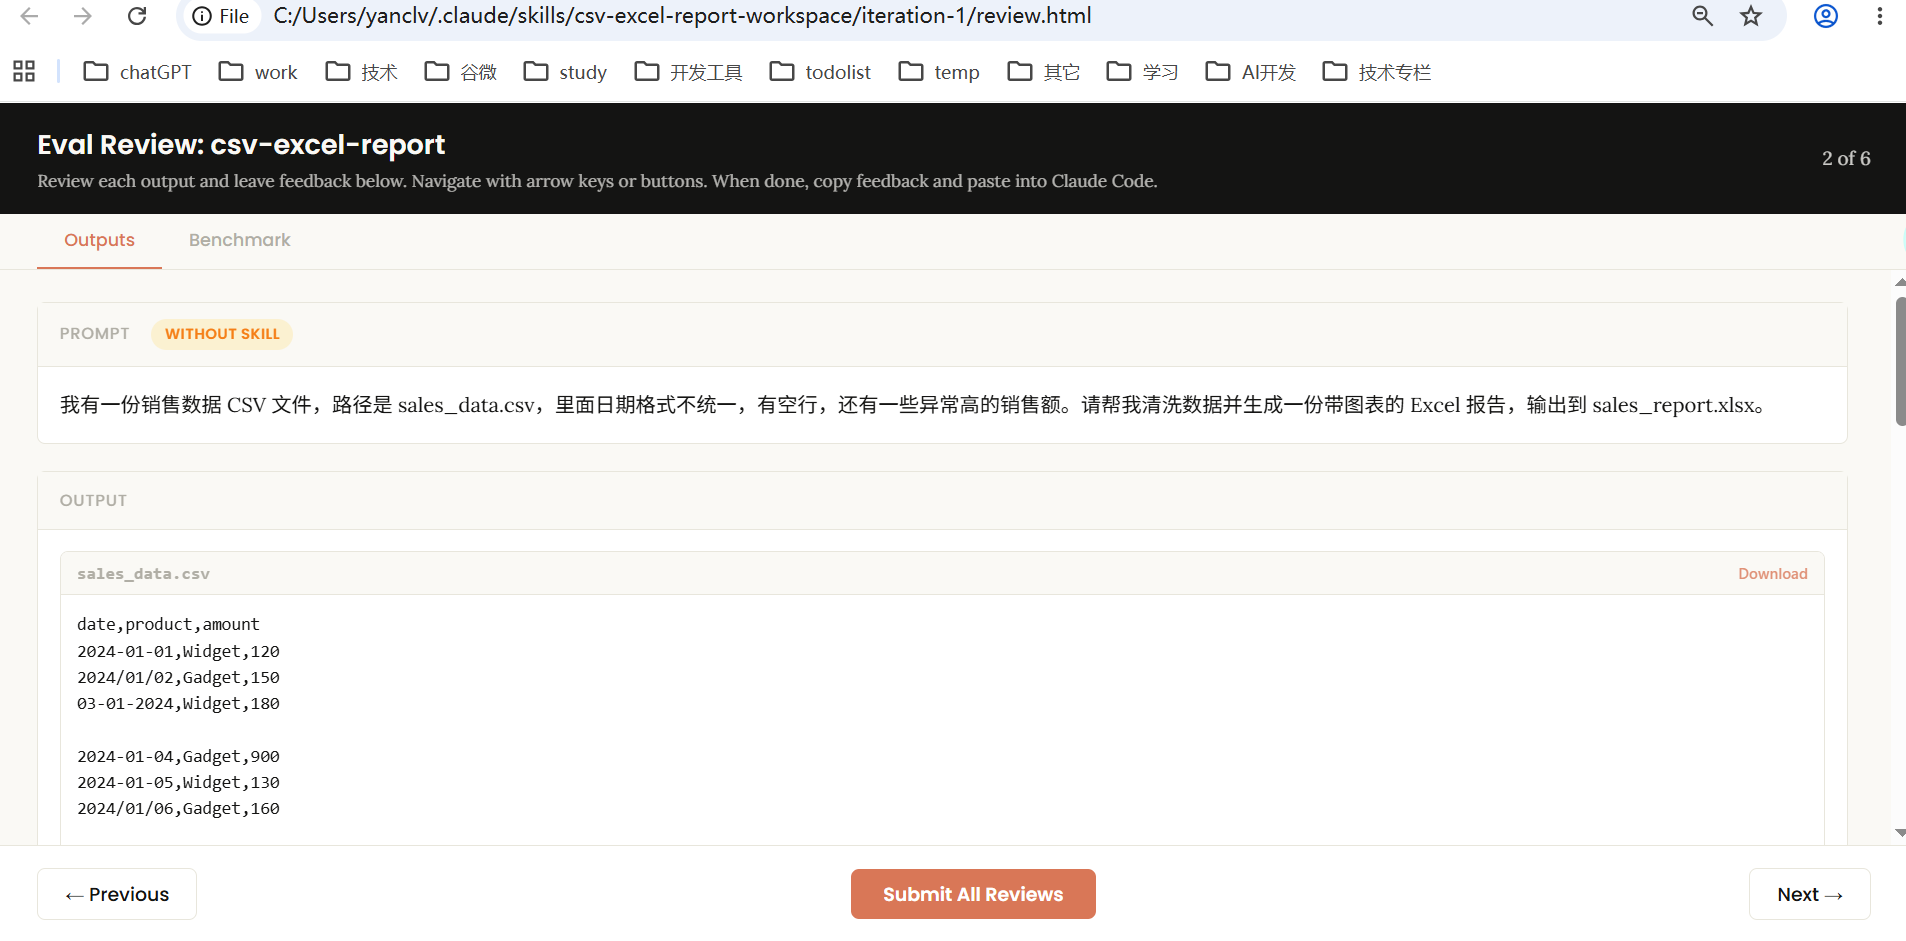
若发现问题或,不满意的地方,拉到下方,可以输入反馈。
点击按钮Submit All Reviews ,下载feedback.json文件
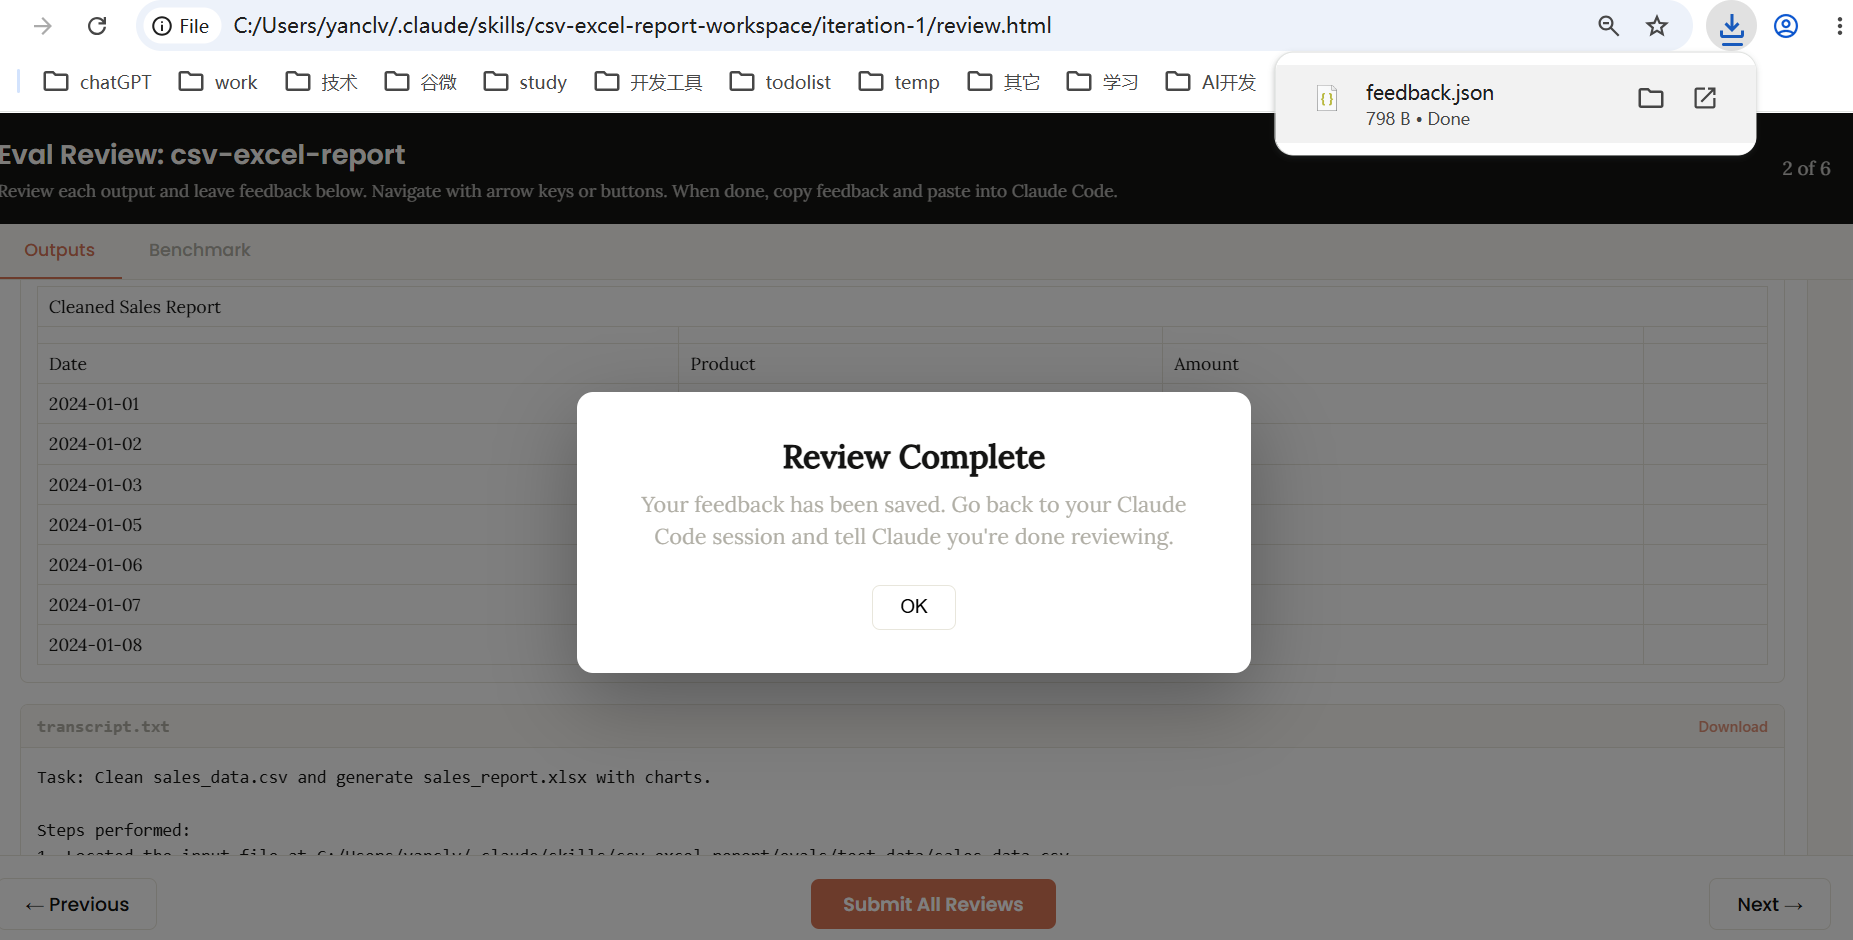
反馈文件feedback.json展示如下:
|
|
完成后,claude code 命令窗口展示:
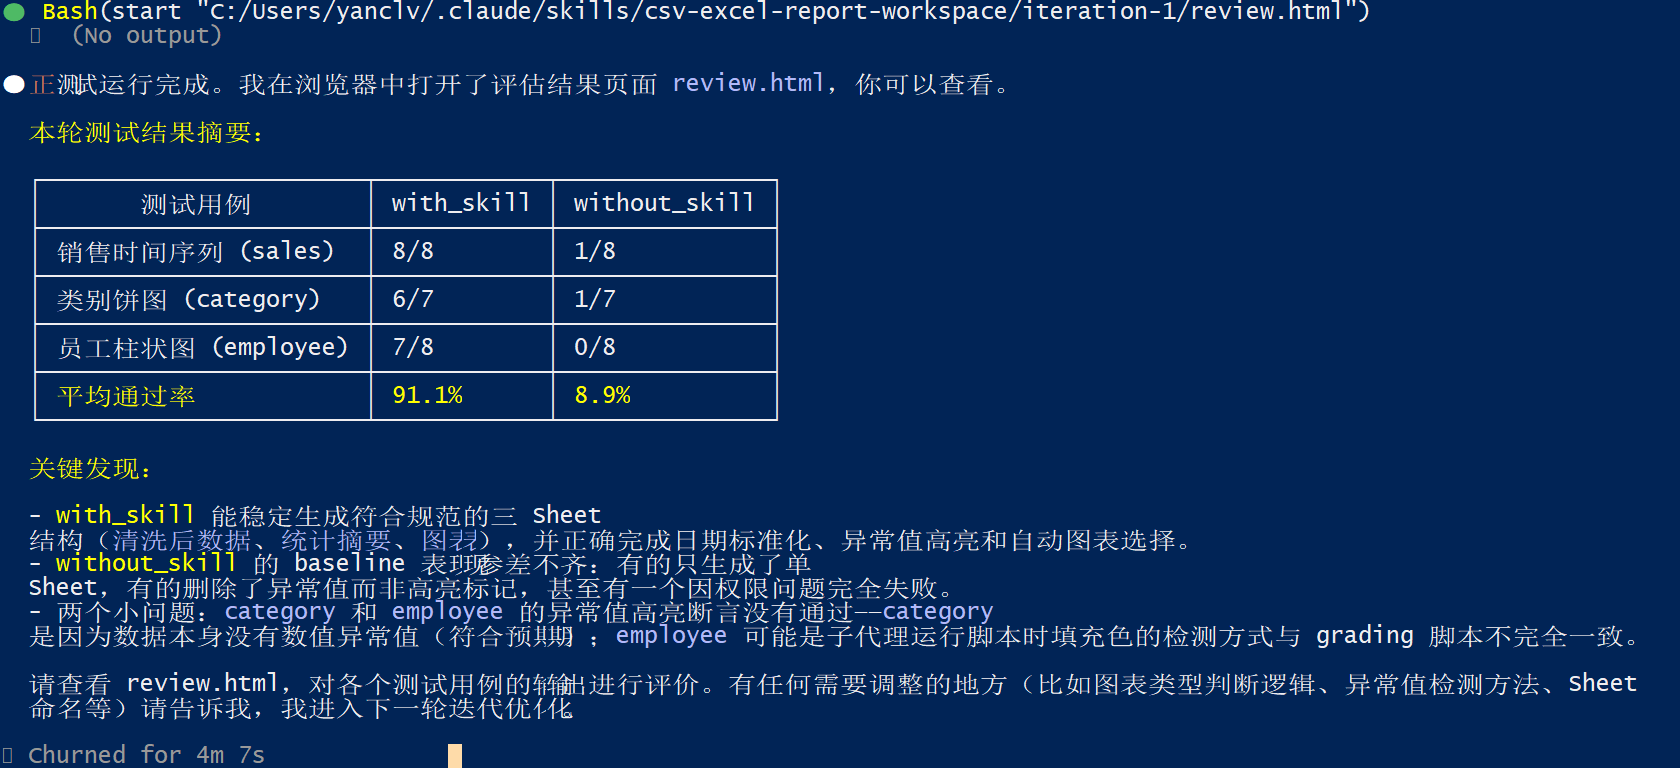
最终生成技能csv-excel-report目录如下:
评测目录如下:
创建的技能csv-excel-report的SKILL.md文件如下:
|
|
还有其它
skill-creator的使用场景功能,可以自行试下哦。以下是使用技能的提示词示例。
场景 B:改进现有 Skill
|
|
场景 C:量化评估 Skill 效果
|
|
场景 D:优化 Skill 触发率
|
|
场景 E:打包分发
|
|
补充学习资源
如您想要系统建立 AI Agent 全栈开发能力,从概念认知到企业级项目落地、线上迭代优化,可以参考《栖微 AI Agent 工程师实战成长营》专栏。专栏以六阶成长路径组织内容,配套实战源码与持续更新的前沿案例,补齐 Demo 到生产环境之间的工程化短板。
Github 项目 :https://github.com/tinyseeking/tidy-agent-practice
欢迎大家一起探讨智能体开发相关问题。