Skill 从入门到精通——第四章 Anthropic 官方Skill解析—doc-coauthoring Skill 解析
doc-coauthoring Skill 解析—文档协同创作
一、技能概述
doc-coauthoring 是 Anthropic 官方发布的结构化文档协同写作 Skill,核心定位是:通过三阶段工作流(Context Gathering → Refinement & Structure → Reader Testing),将用户隐性的领域知识高效转化为对读者有效的高质量结构化文档。
触发场景:
- 用户提及写作意图:“write a doc”, “draft a proposal”, “create a spec”, “write up”
- 用户提及特定文档类型:“PRD”, “design doc”, “decision doc”, “RFC”
- 用户似乎正在启动一项实质性写作任务
二、项目文件结构
该 Skill 采用 Anthropic Skills 规范的最简结构——单文件 Skill,无辅助脚本、无外部依赖、无配置目录。
|
|
架构特征:
- 零外部依赖:无 Python/JS 代码、无配置文件、无工具脚本,纯 Markdown 语义驱动。
- 单文件自治:全部行为定义、触发条件、阶段逻辑、边界处理、质量策略均内聚于
SKILL.md。 - 声明式控制:通过 frontmatter 声明技能元数据,通过 Markdown 标题层级组织决策树与指令块。
三、核心决策树
Skill 激活后,Claude 依据以下决策树执行:
|
|
四、SKILL.md 结构概览
|
|
五、主要工作流
Skill 定义了一条三阶段端到端工作流,-严格串行推进:
Stage 1: Context Gathering(上下文收集)
目标:缩小用户所知与 Claude 所知之间的认知差距,为后续智能指导建立知识基线。
执行步骤:
- 初始元问题:抛出5个结构化问题(文档类型、受众、期望影响、模板/格式、其他约束),允许用户速记回答。
- 模板/集成探测:若用户提及模板或共享文档,探测可用集成(MCP Servers / Connectors)自动拉取;若编辑现有文档,检查图片 alt-text 缺失(无障碍与 AI 可读性双重考量)。
- 信息倾倒(Info Dumping):鼓励用户无组织地倾倒所有背景信息(项目背景、团队讨论、替代方案排除理由、组织政治、时间线、技术架构、利益相关者顾虑)。提供多种输入方式:意识流、频道链接、文档链接。
- 集成自适应:检测到 Slack/Teams/Drive/SharePoint 等 MCP 集成时主动调用;无集成时建议用户在 Claude 设置中启用 Connectors。
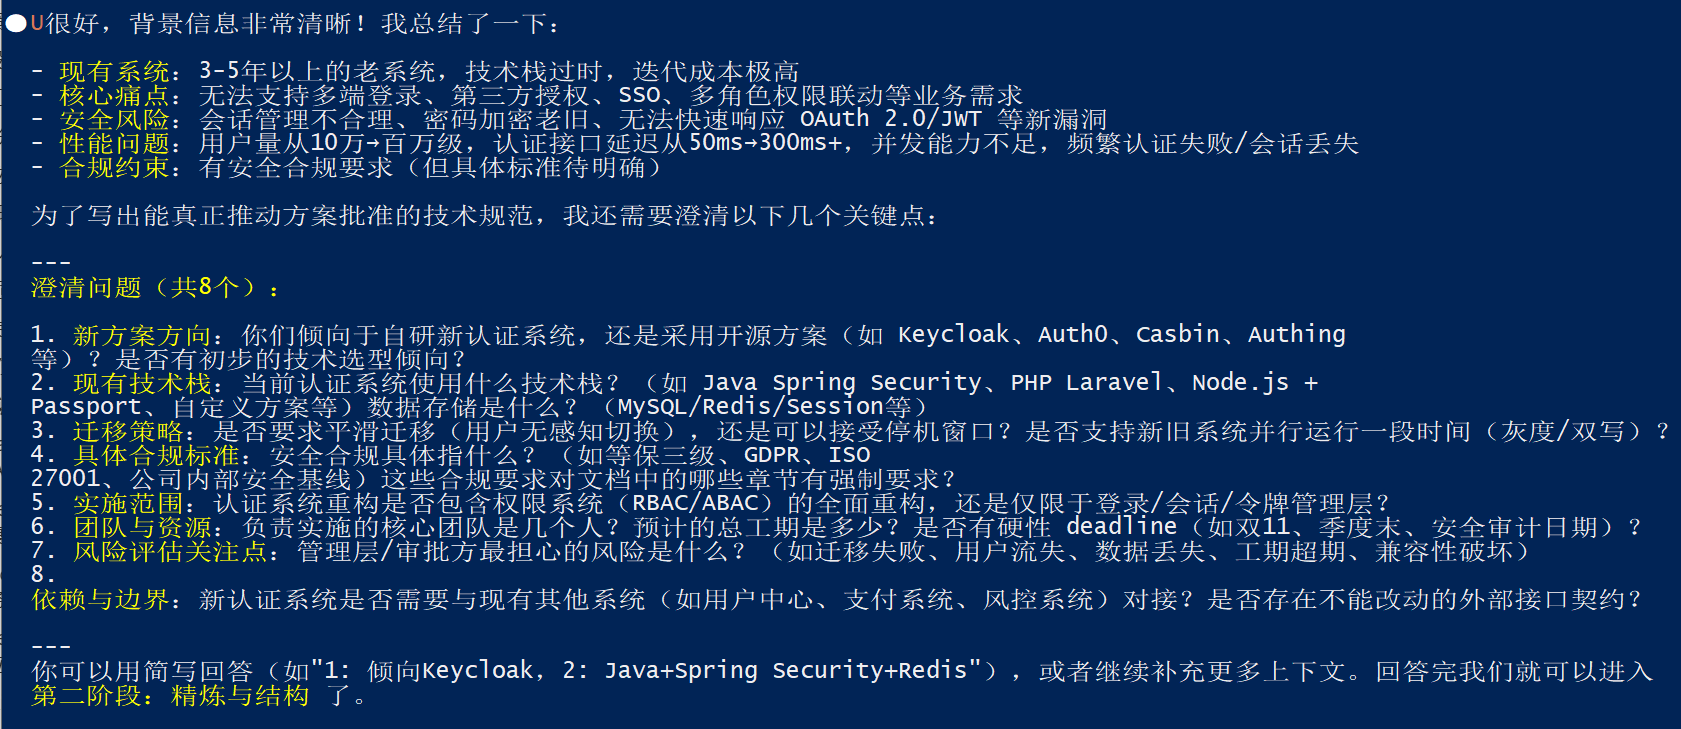
- 澄清追问:用户完成初始倾倒后,生成 5-10 个编号问题,聚焦上下文缺口。用户可用速记、链接或继续倾倒回答。
- 退出判定:当问题显示出理解时——当可以在不需要解释基础的情况下询问边缘情况和权衡时,视为已收集到足够的上下文。
Stage 2: Refinement & Structure(精修与结构化)
目标:通过逐节构建、Brainstorm-Curation-Draft-Refine 闭环,产出高质量文档。
执行步骤:
-
章节排序策略:从"最多未知数的章节"开始(决策文档的核心提案、技术规范的技术方案),摘要部分最后处理。
-
骨架创建:
- Artifacts 可用:调用
create_file创建 Artifact,生成带[To be written]占位符的完整章节骨架。 - 无 Artifacts:在工作目录创建
.md文件(如decision-doc.md)。
- Artifacts 可用:调用
-
逐节6步循环(每章节重复):
- Step 1 Clarifying Questions(澄清问题):针对当前章节生成 5-10 个具体问题。
- Step 2 Brainstorm(头脑风暴):生成 5-20 个编号选项(复杂度自适应),覆盖用户可能遗忘的上下文角度。
- Step 3 Curation(筛选整合):用户通过编号选择保留/删除/合并(如 “Keep 1,4,7,9”),Claude 解析自由形式反馈。
- Step 4 Gap Check(缺口检查):基于用户选择,询问是否有重要遗漏。
- Step 5 Drafting(起草):使用
str_replace替换占位符为实际内容(绝不重印全文)。 - Step 6 Iterative Refinement(迭代优化):根据用户反馈手术级编辑,迭代至满意。
-
质量检查:连续3次迭代无实质变更时,主动提议删减(“能否在不丢失信息的前提下删除内容?")。
-
近完成审查(80%+):全文重读,检查跨节一致性、冗余、矛盾、“slop”(通用填充内容)。
Stage 3: Reader Testing(读者测试)
目标:用零上下文 Claude 实例验证文档对真实读者的有效性,捕获作者盲区。
双路径执行:
路径 A:子代理可用(Claude Code)
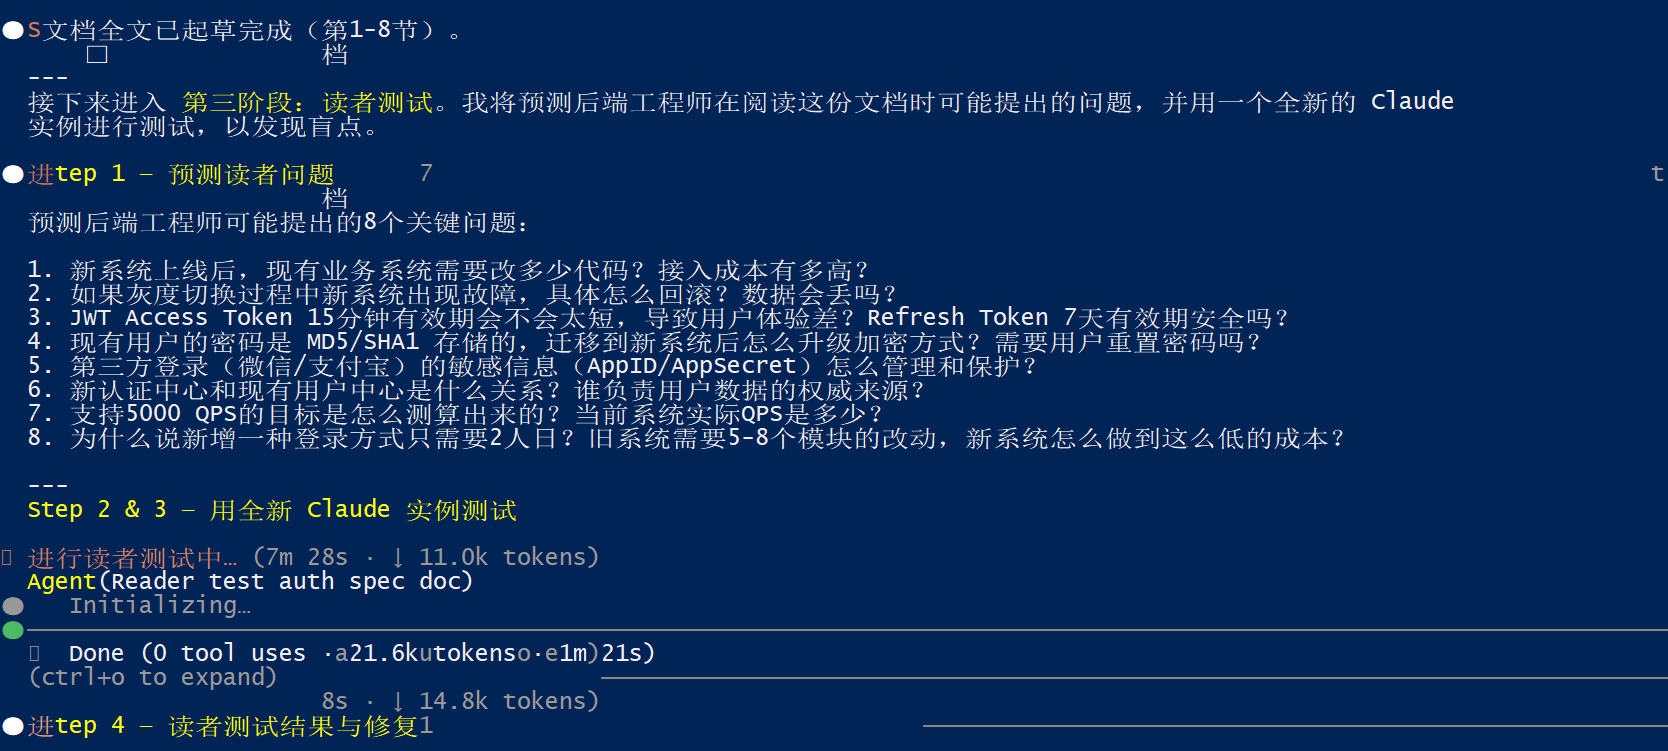
- 预测问题:生成 5-10 个读者可能提出的问题。
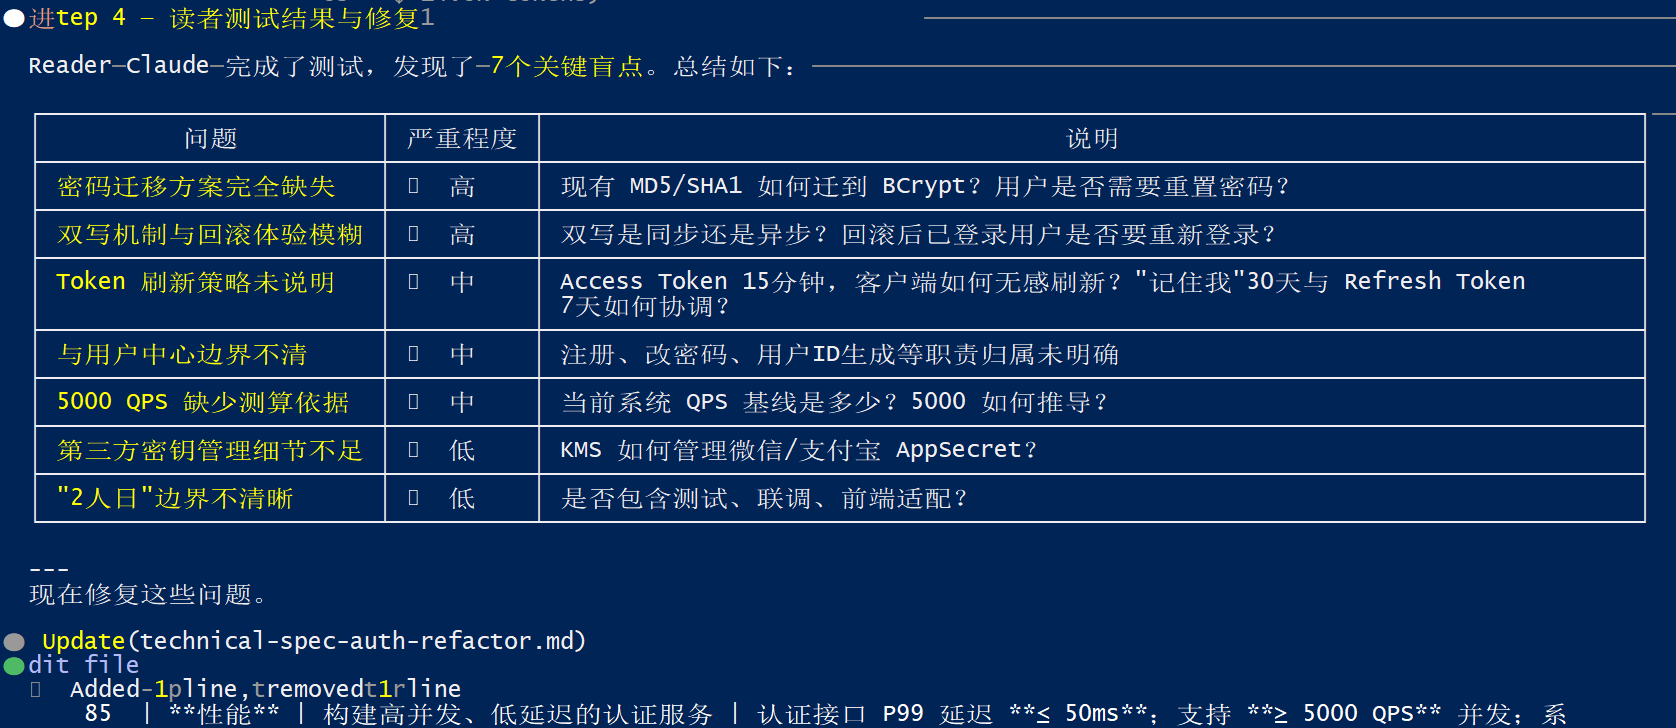
- 子代理测试:对每个问题,调用子代理(全新的 Claude 实例,Reader Claude)对这些问题作答,无本对话上下文,仅传入文档内容+问题,汇总 Reader Claude 对每个问题的正确/错误之处。
- 额外检查:调用子代理检查歧义、错误假设、内部矛盾。
- 修复循环:发现问题 → 列出具体问题 → 回退至 Stage 2 精修。
路径 B:子代理不可用(Claude.ai Web)
- 预测问题:同上。
- 手动测试指导:指导用户打开新 Claude 对话(https://claude.ai),粘贴文档,逐问测试。
- 额外检查清单:要求 Reader Claude 回答三个元问题(歧义点、假设知识、内部矛盾)。
- 迭代修复:收集 Reader Claude 的困惑点,回退精修。
退出条件:Reader Claude 能一致正确回答且不再暴露新缺口/歧义。
六、核心机制解析
1、上下文传递的三层漏斗(Context Funnel)
Stage 1 采用漏斗式信息收敛策略:
- 元问题层(结构化):5个高阶(文档类型、受众、期望影响、模板/格式、约束)问题快速框定文档边界。
- 倾倒层(非结构化):鼓励用户倾倒他们拥有的所有上下文,不必担心组织,最大化信息熵。
- 追问层(靶向性):基于已收集上下文生成缺口问题,精准补全。
底层原理:
- 认知负荷分配:元问题降低用户启动成本(只需回答5个简单问题),倾倒层释放用户记忆缓存,追问层由 Claude 承担组织负担(“你来说,我来问”)。
- 集成探测逻辑:在倾倒阶段主动检测上下文源(Slack 频道、Drive 文档、Teams 线程),通过 MCP 集成自动拉取,避免手动复制粘贴的信息损耗。
- alt-text 检查:编辑现有文档时,检查图片 alt-text 缺失——这是AI 可读性工程的关键细节:当其他用户将文档粘贴到 Claude 时,无 alt-text 的图片对 Claude 完全不可见。
2、Brainstorm-Curation-Draft 闭环(BCD Loop)
Stage 2 的核心是节级六步循环,其设计遵循"发散 → 收敛 → 固化 → 精修"的创作规律:
| 步骤 | 动作 | 工具/方法 | 设计目的 |
|---|---|---|---|
| 1 | 澄清问题 | 对话(5-10 个问题) | 缩小该节的信息缺口 |
| 2 | 头脑风暴 | 对话(5-20 个编号选项) | 发散探索,防止遗漏 |
| 3 | 筛选 | 对话(keep/remove/combine) | 用户主权决策,Claude 学习偏好 |
| 4 | 缺口检查 | 对话 | 防止"选完即对"的确认偏误 |
| 5 | 起草 | str_replace 替换占位符 |
将共识固化为文本 |
| 6 | 迭代精炼 | str_replace 局部编辑 |
精准打磨,禁止全文重印 |
底层原理:
- 选项过载管理:Brainstorm 阶段生成 5-20 个选项(而非一次性生成完整内容),降低用户认知负荷,将"创作"转化为"选择”。
- 筛选整合(Curatorial Writing):用户通过编号选择(“Keep 1,4,7,9”)表达意图,Claude 负责解析自由形式反馈并映射到结构化操作——这是人机协作的交互协议设计。
- 手术级编辑(Surgical Editing):强制使用
str_replace而非全文重印,确保:- 上下文窗口高效利用(避免重复传输未变更内容)
- 编辑原子性(每次变更可独立追踪与回滚)
- 用户注意力聚焦(仅展示变更部分)
3、零上下文读者测试(Fresh Claude Test)
源码设计:
|
|
底层原理:
- 作者盲区(Curse of Knowledge):作者因掌握背景知识而难以感知文档的模糊点。Fresh Claude Test 通过上下文隔离模拟真实读者的零知识状态。
- 子代理架构:在 Claude Code 环境中,Skill 指导 Claude 调用子代理(sub-agent)执行测试——这是元认知外包:主对话的 Claude 保留完整上下文负责写作,子代理仅接收文档内容负责阅读验证,两者形成写作-阅读对抗网络。
- 对抗性验证:通过预测读者问题 → 子代理回答 → 比对预期与实际,构建自动化文档质量门禁。
4、Artifact 与文件系统的自适应策略
Skill 对文档载体的选择遵循环境自适应原则:
|
|
环境感知:Skill 不假设 Artifacts 一定可用(Claude Code CLI 与 Claude.ai Web 的能力差异),通过条件分支实现能力降级优雅处理。
七、设计通用启示
1、工作流即代码
doc-coauthoring 证明:复杂的交互工作流可以完全通过声明式 Markdown 指令实现,无需传统编程语言。其本质是将对话状态机编码为标题层级、条件段落与退出条件。
2、分阶段推进 + 退出条件
- 每个阶段有明确的退出条件(Stage 1: 能追问边缘案例; Stage 3: 读者测试一致通过)
- 避免无限循环:3轮无改动触发器、用户拒绝即退场
- 启示: 工作流型 Skill 必须设计可观测的退出条件,否则容易陷入无限迭代
3、发散-收敛漏斗
- 每个章节的6步循环本质是一轮发散-收敛
- 头脑风暴数量有明确区间(5-20),防止过度发散或不足
- 启示: 结构化创作任务应先发散再收敛,避免过早收敛导致遗漏
4、环境检测而非环境假设
- 不假设运行环境,运行时通过条件指令动态适配
- Stage 3 的子代理/手动双路径展示了 Skill 的运行时感知能力。单一 Skill 通过条件逻辑适配不同运行时环境,最大化复用性而不牺牲环境特性。
- 启示: Skill 应设计为跨环境可运行,通过检测而非配置来适配
5、人机协作协议
- 策展优于创作:让用户做选择题(Keep/Remove/Combine)而非填空题,降低认知负荷。
- 手术级编辑:
str_replace替代全文重印,是上下文窗口管理与用户注意力管理的关键。 - 对抗性验证:引入"零上下文读者"概念,将质量验证从主观感受转化为可执行的客观测试。
6、质量工程红线
- 连续3次无实质变更 → 主动提议删减:防止过度打磨与冗余膨胀。
- 80%完成度触发全文审查:避免早期章节的假设与后期章节冲突。
- “slop"检测:明确将"通用填充内容"列为审查目标,对抗 LLM 的"安全但空洞"倾向
八、使用示例
1、使用场景
| 场景 | 文档类型 | 核心价值 |
|---|---|---|
| 技术决策 | Architecture Decision Record (ADR) | 通过 Reader Testing 验证技术方案对非技术利益相关者的可理解性 |
| 产品规划 | Product Requirements Doc (PRD) | 利用 Brainstorm-Curation 穷尽需求场景,避免遗漏边缘案例 |
| 项目提案 | Technical Proposal / RFC | 上下文收集阶段自动拉取 Slack 讨论与 Drive 背景文档,确保提案基于完整信息 |
| 规范制定 | API Spec / Design Doc | 分节构建确保每个接口/模块的约束条件被显式讨论而非隐含假设 |
| 复盘文档 | Post-mortem / Incident Report | 信息倾倒阶段鼓励无过滤输入(包括组织政治与人为因素),避免 sanitized 版本 |
2、调用示例
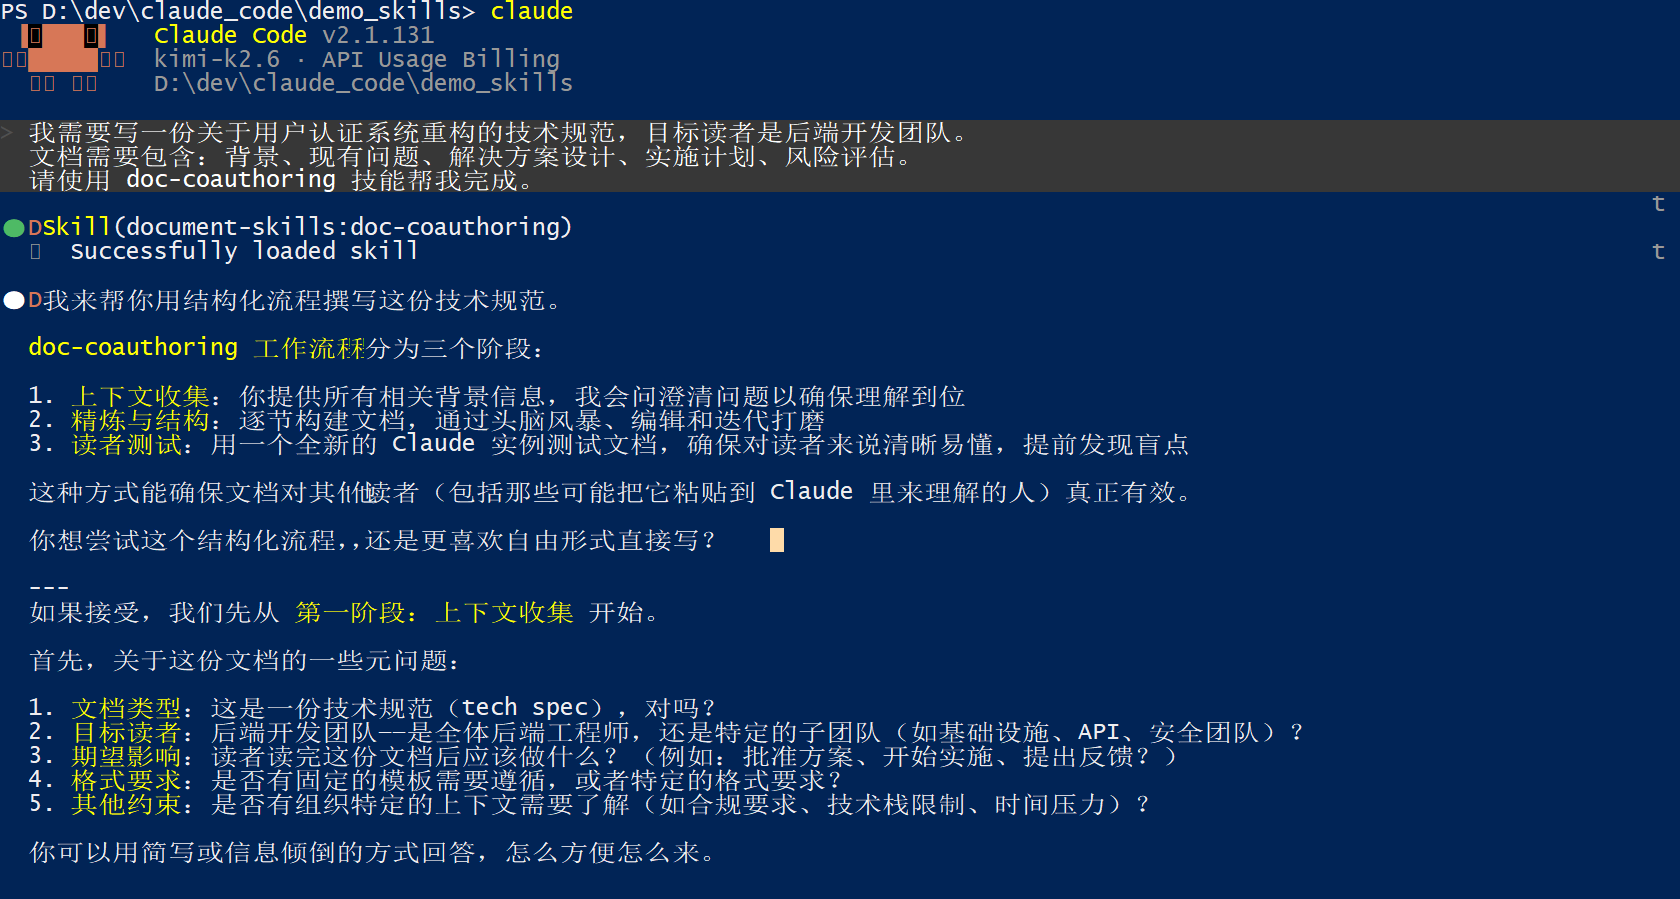
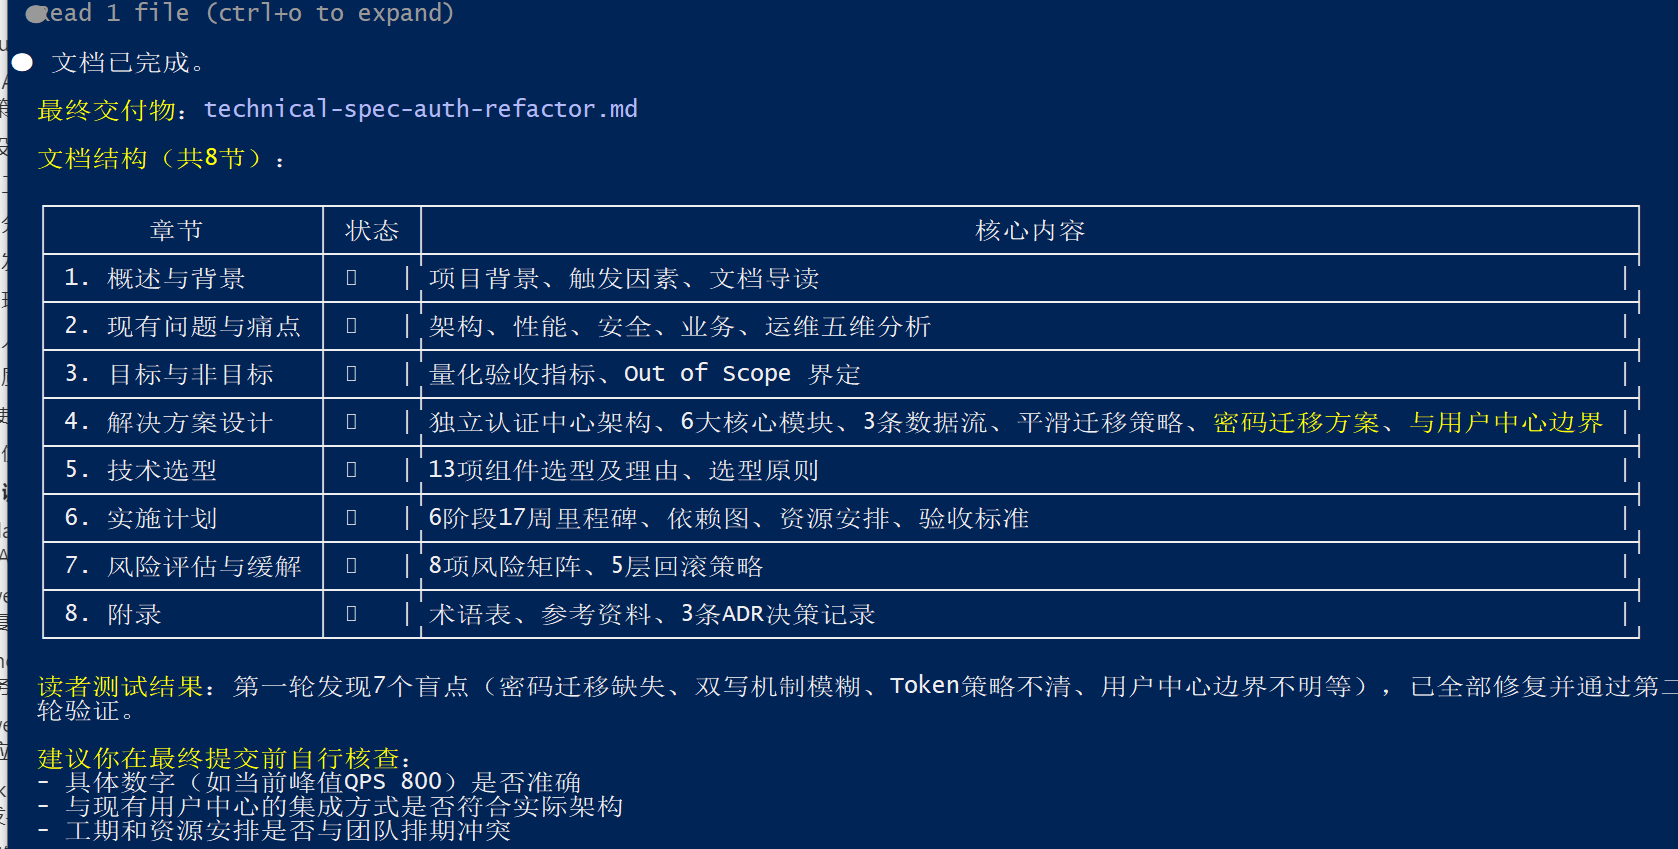
示例 1:技术规范文档
在Claude code中输入指令:
|
|
执行过程部分展示如下:
Stage 1: Context Gathering(上下文收集):抛出5个结构化问题(文档类型、受众、期望影响、模板/格式、其他约束)
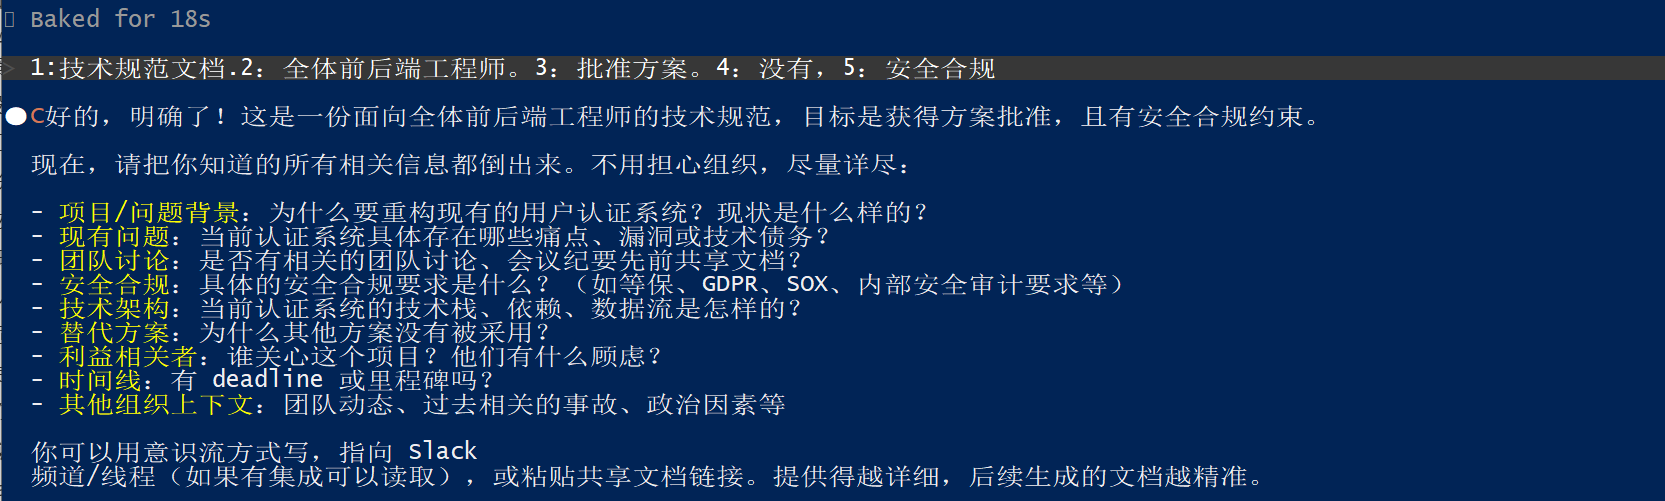
Stage 1:信息倾倒(Info Dumping):鼓励用户无组织地倾倒所有背景信息(项目背景、团队讨论…)
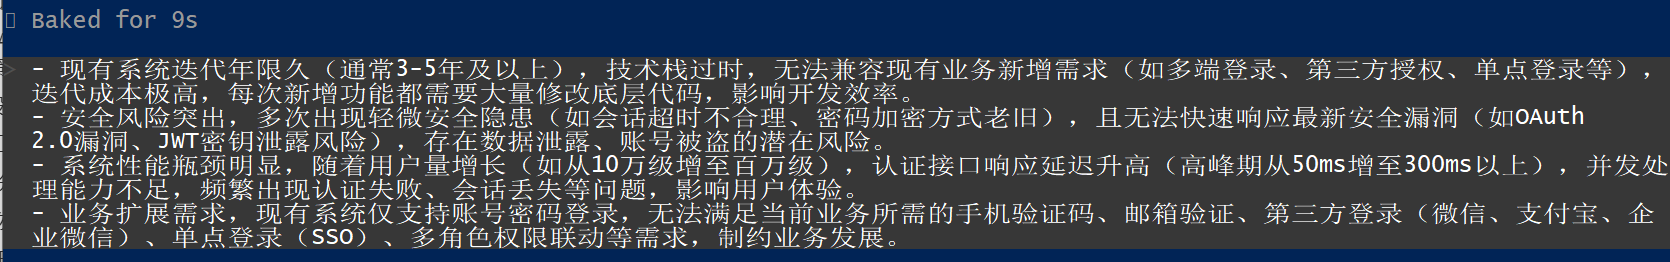
Stage 1:澄清追问:用户完成初始倾倒后,生成 5-10 个编号问题,聚焦上下文缺口。用户可用速记、链接或继续倾倒回答。
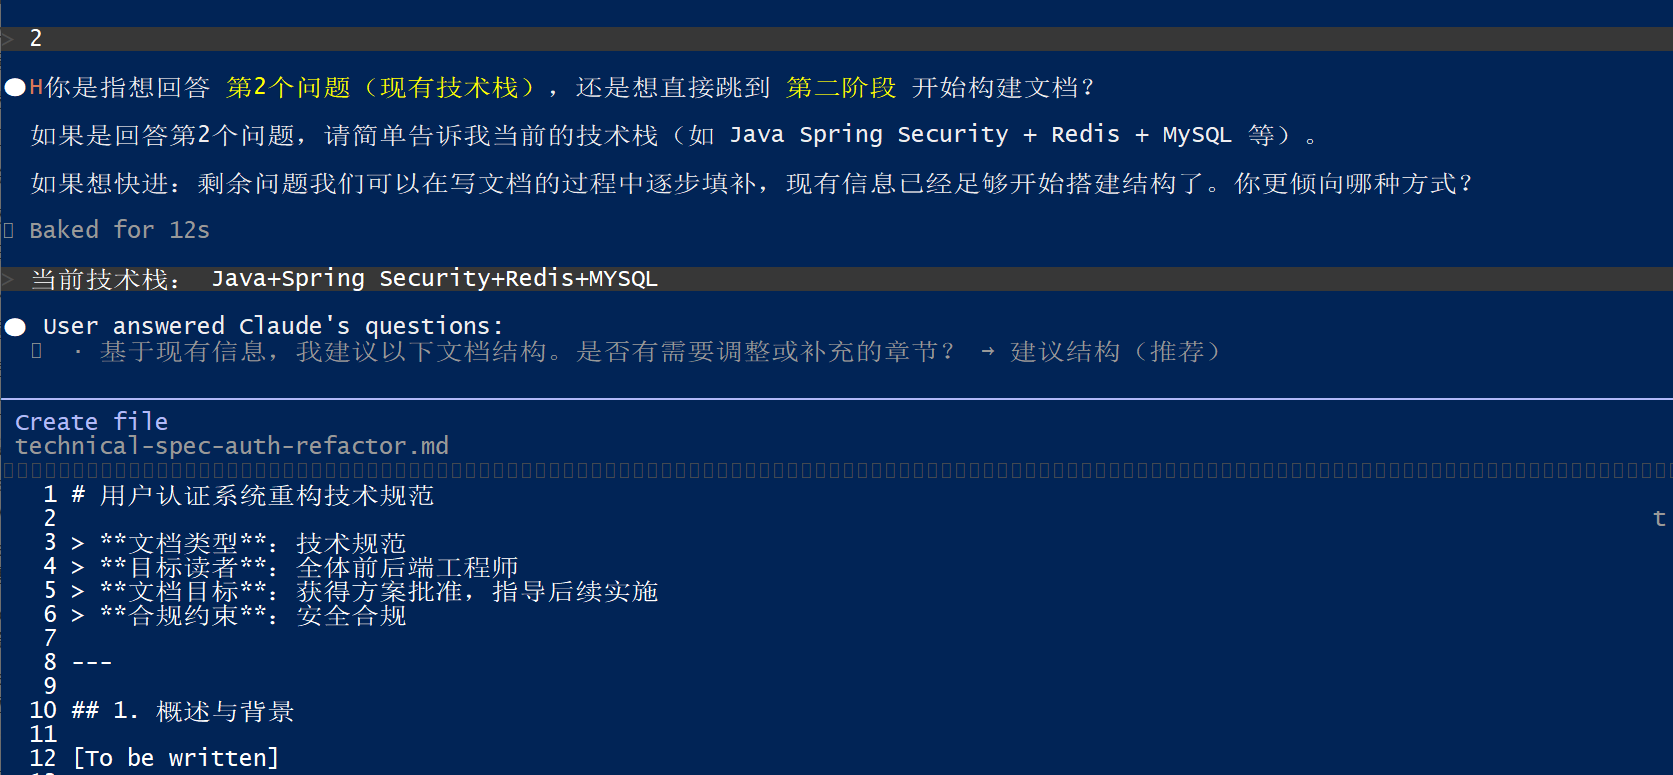
Stage 2: Refinement & Structure(精修与结构):通过逐节构建、Brainstorm-Curation-Draft-Refine 闭环(逐节6步循环),产出高质量文档。
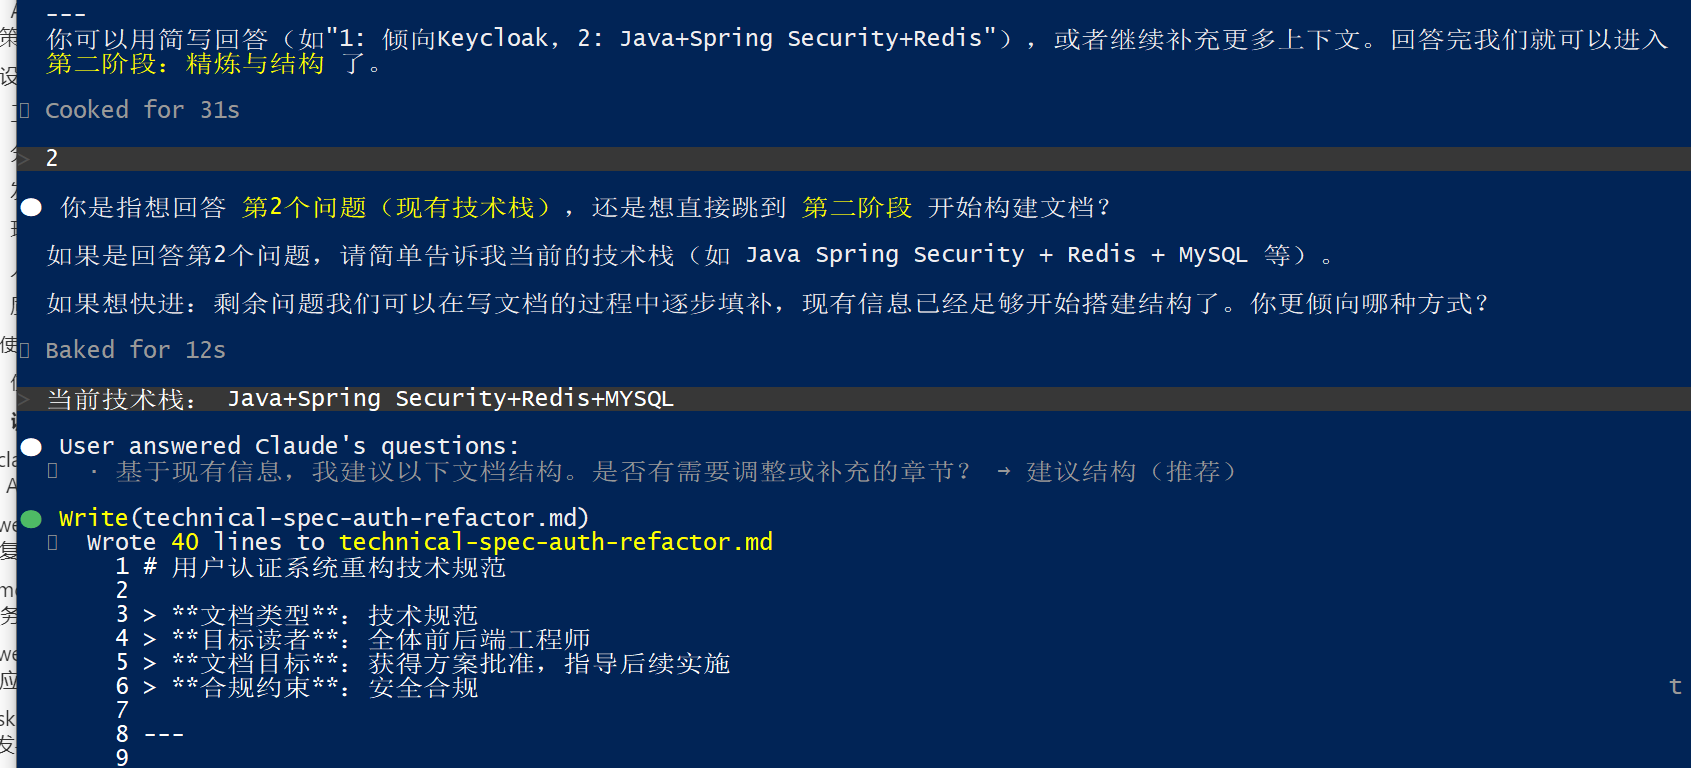
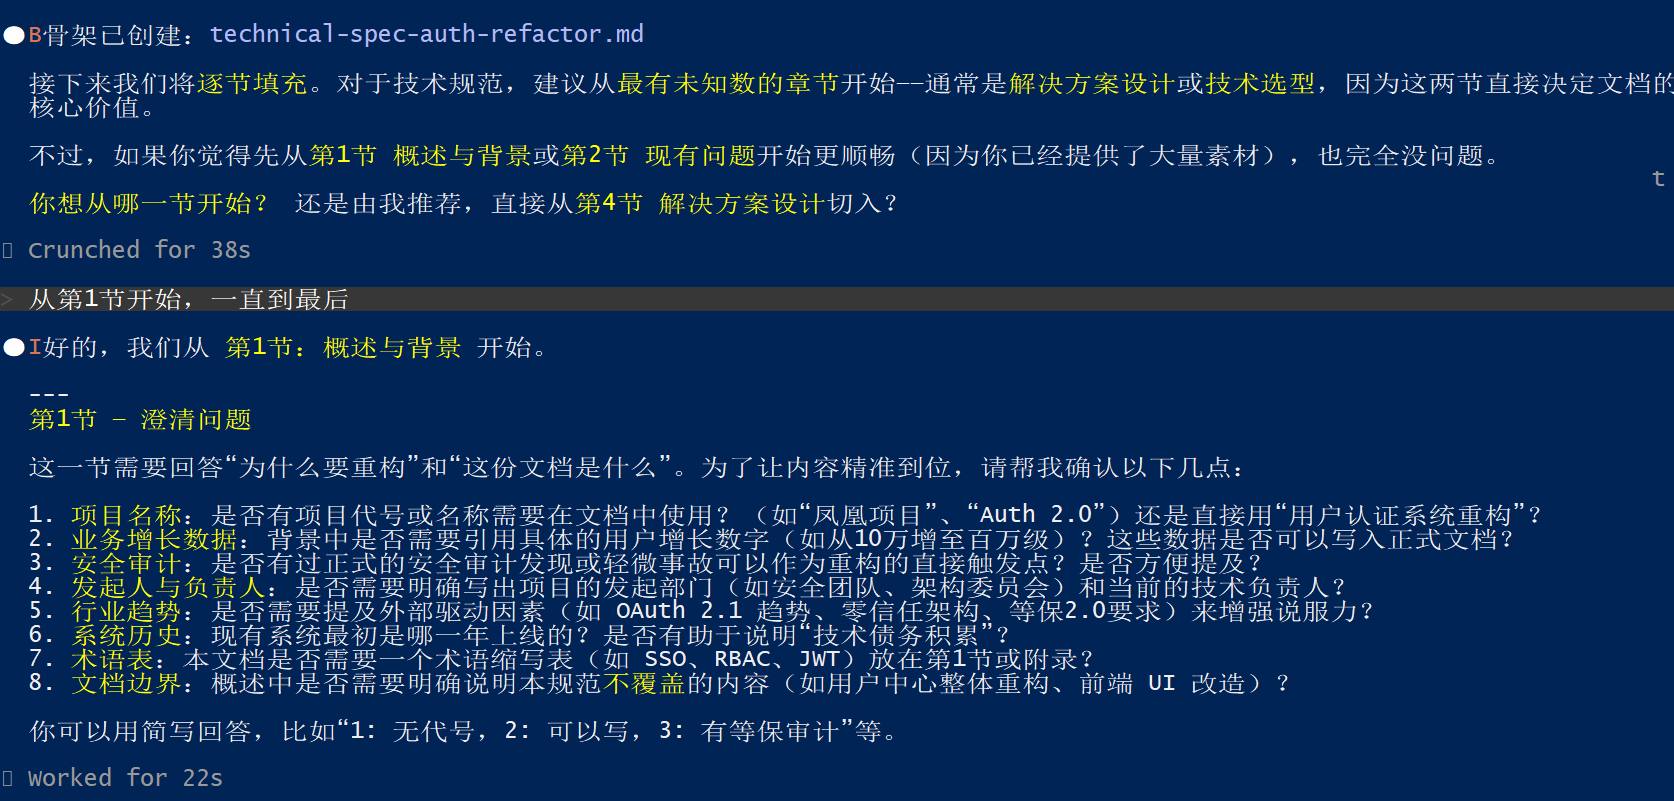
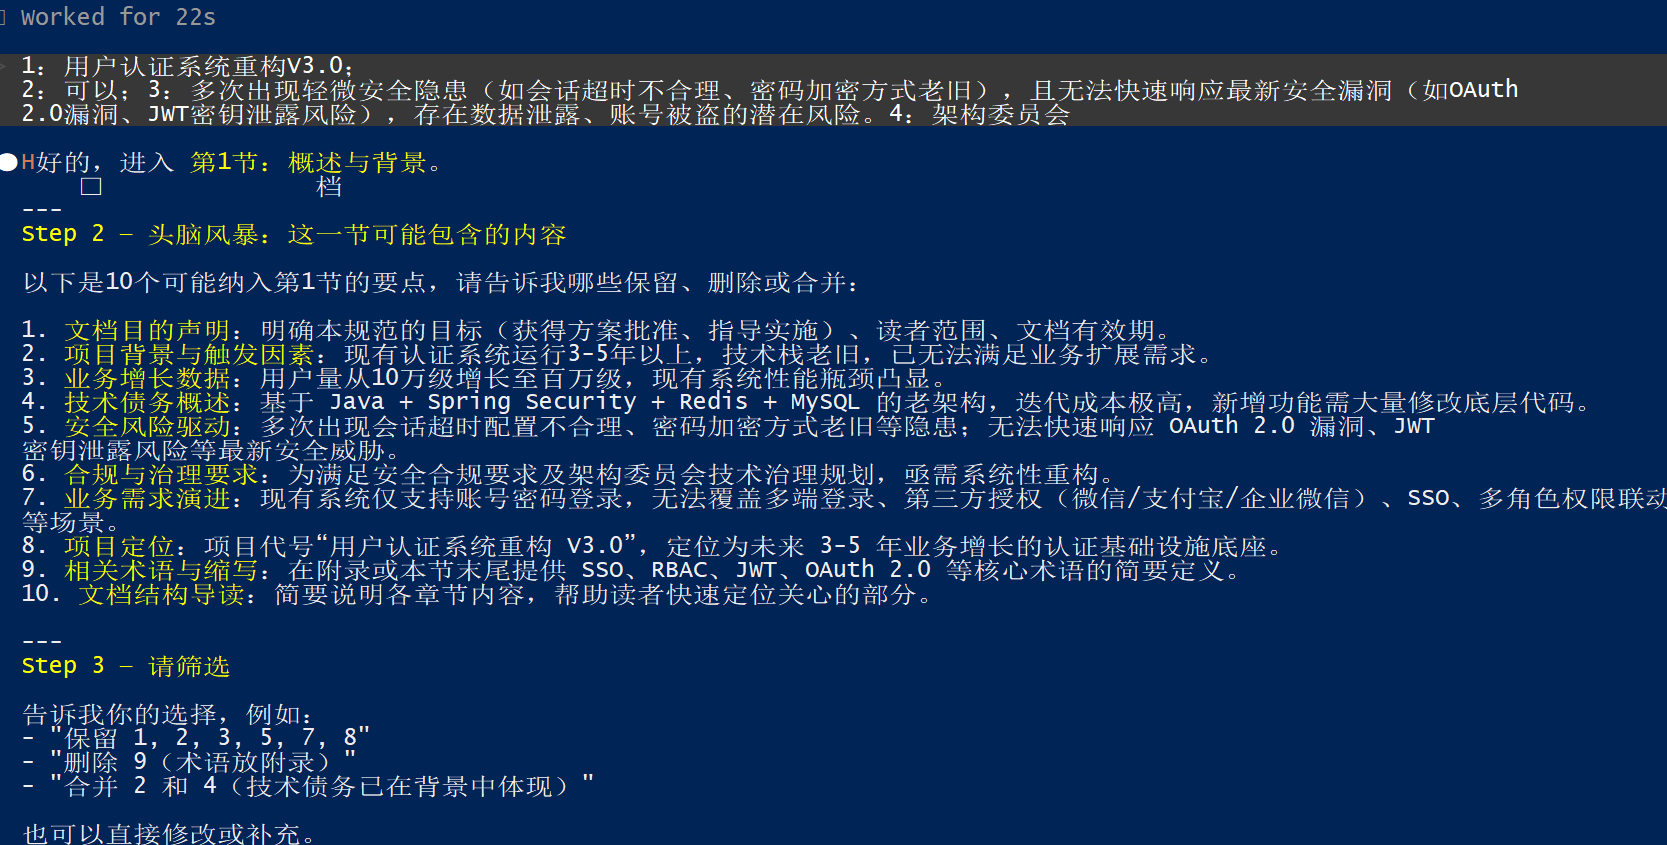
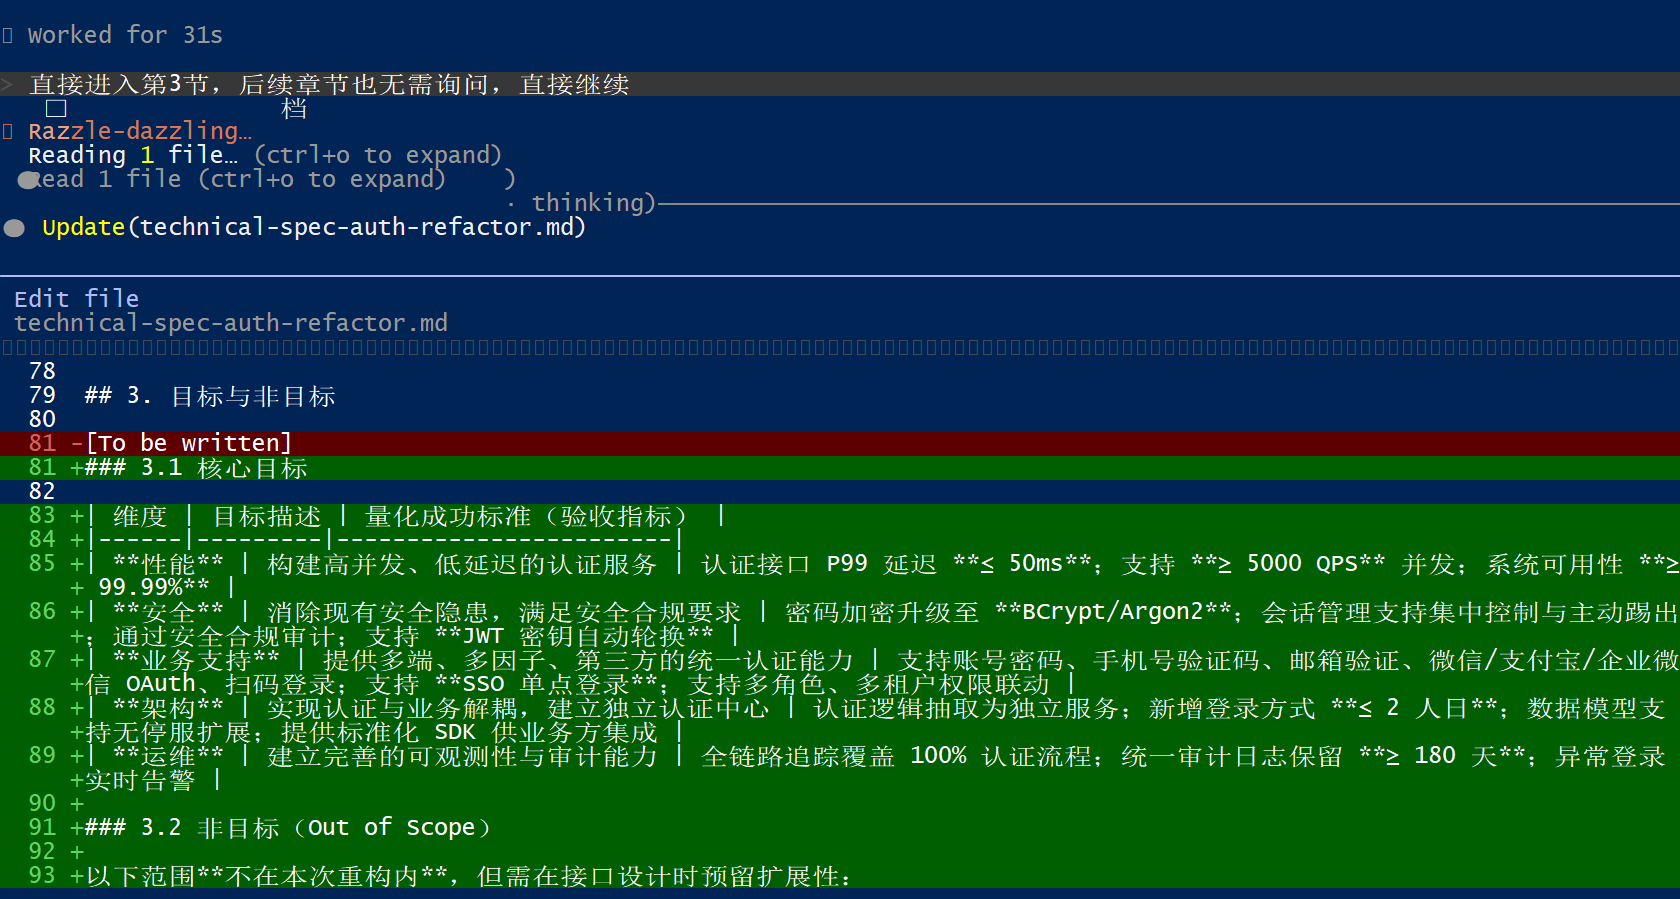
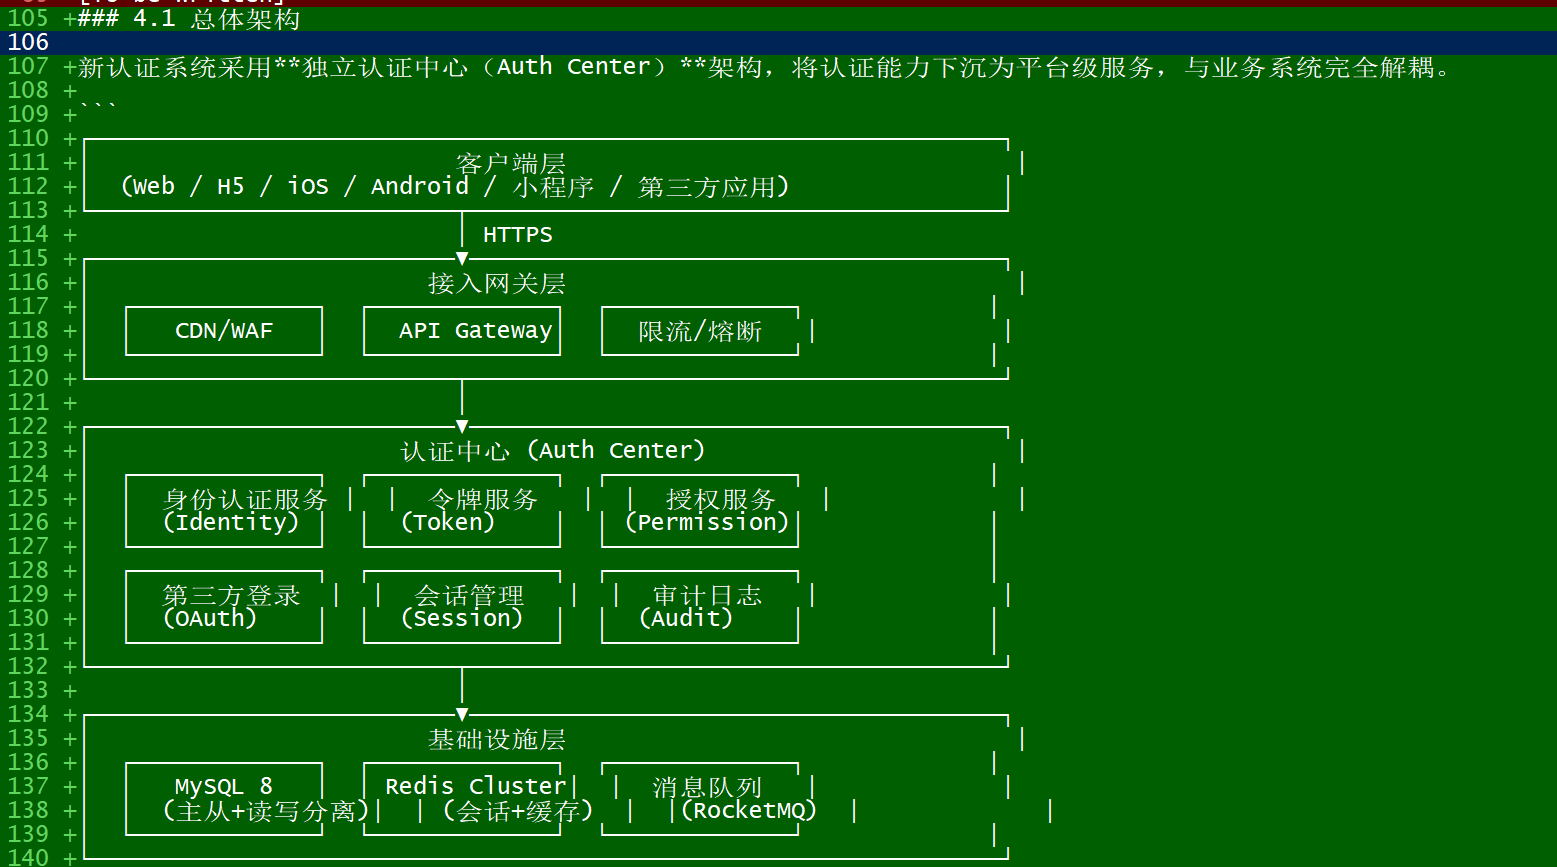
Stage 3: Reader Testing(读者测试):用零上下文 Claude 实例验证文档对真实读者的有效性,捕获作者盲区。
示例 2:技术教程写作
在Claude code中输入指令:
|
|
执行过程部分展示如下:
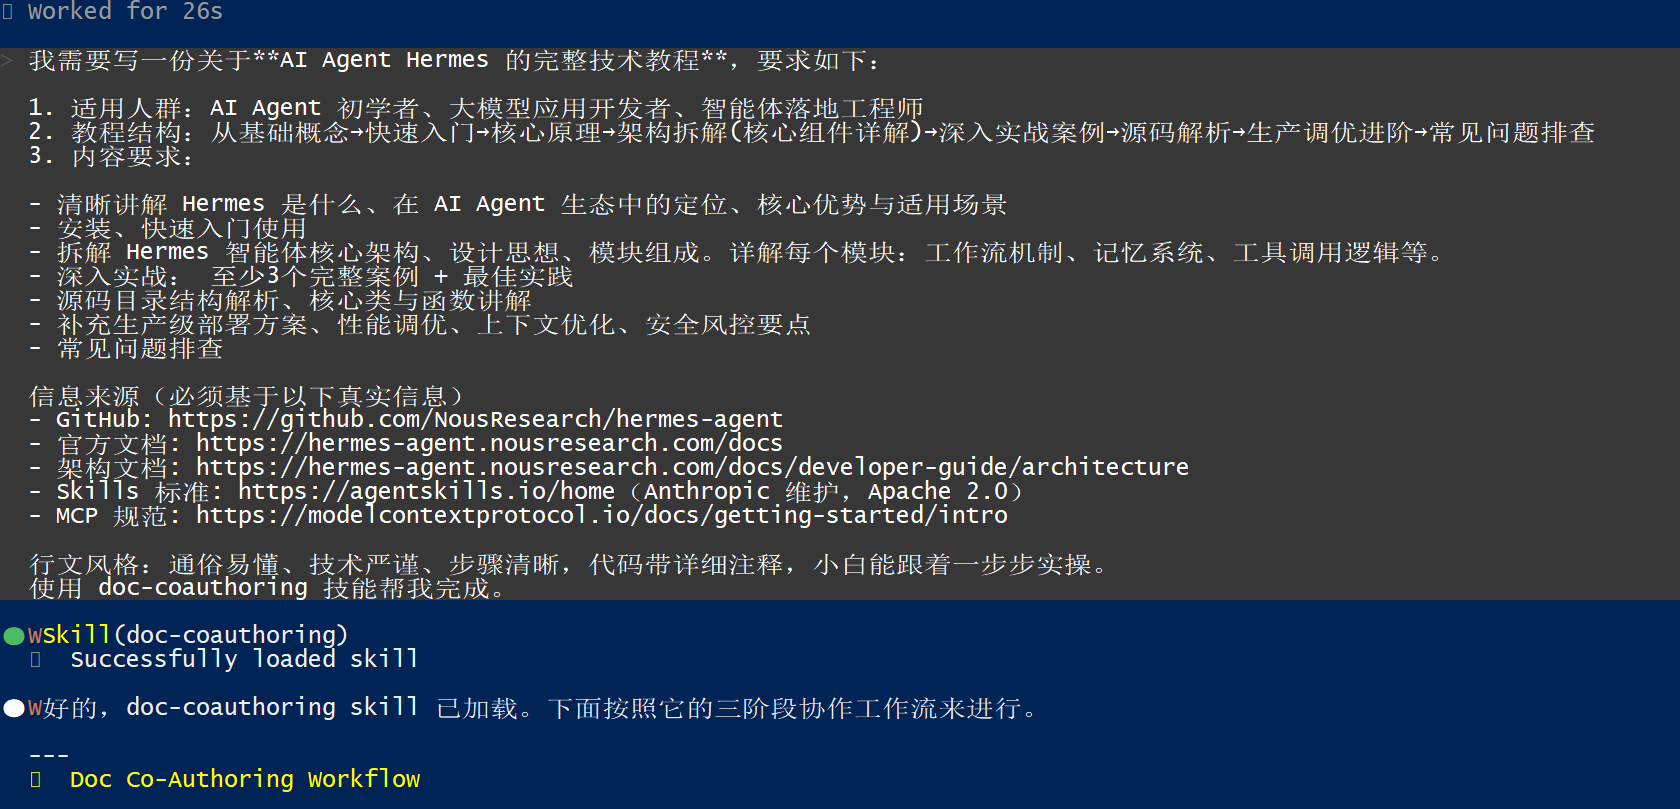
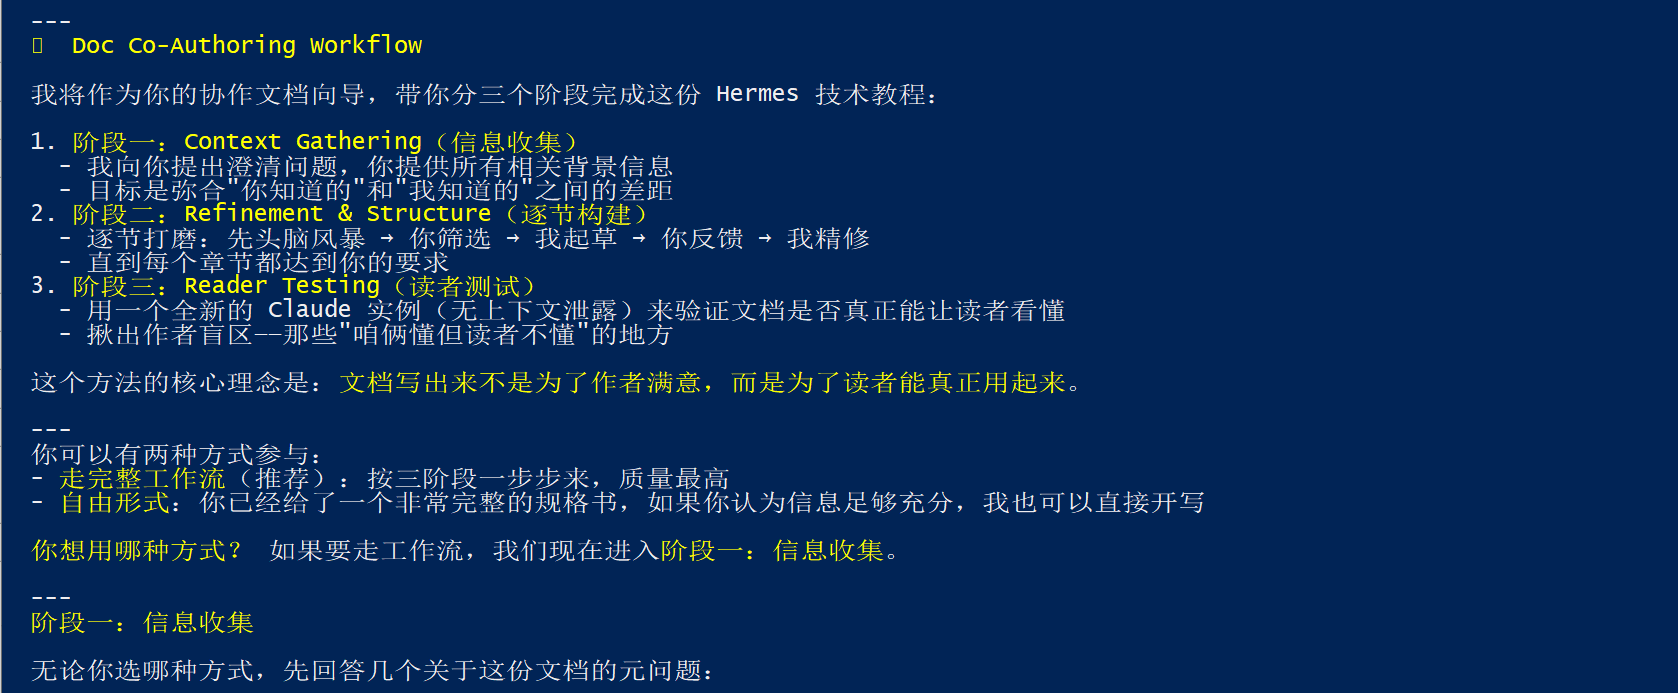
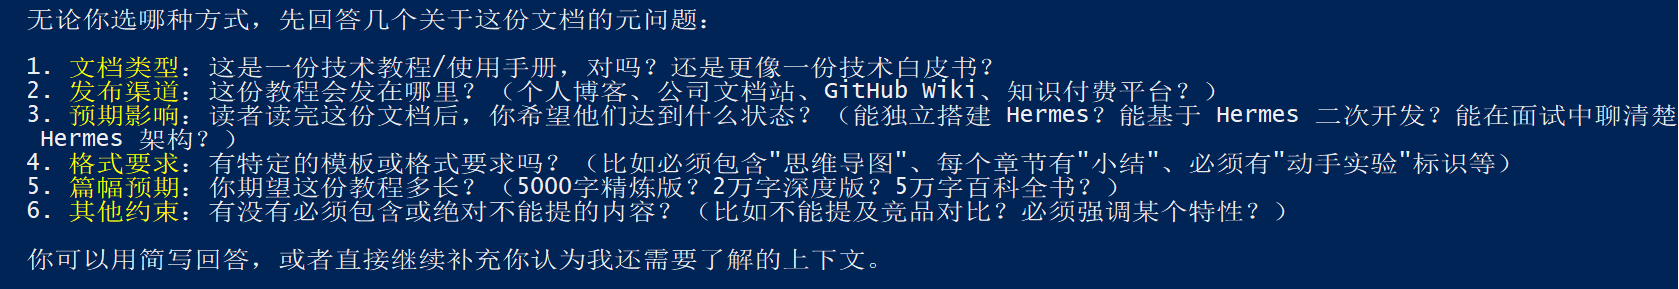
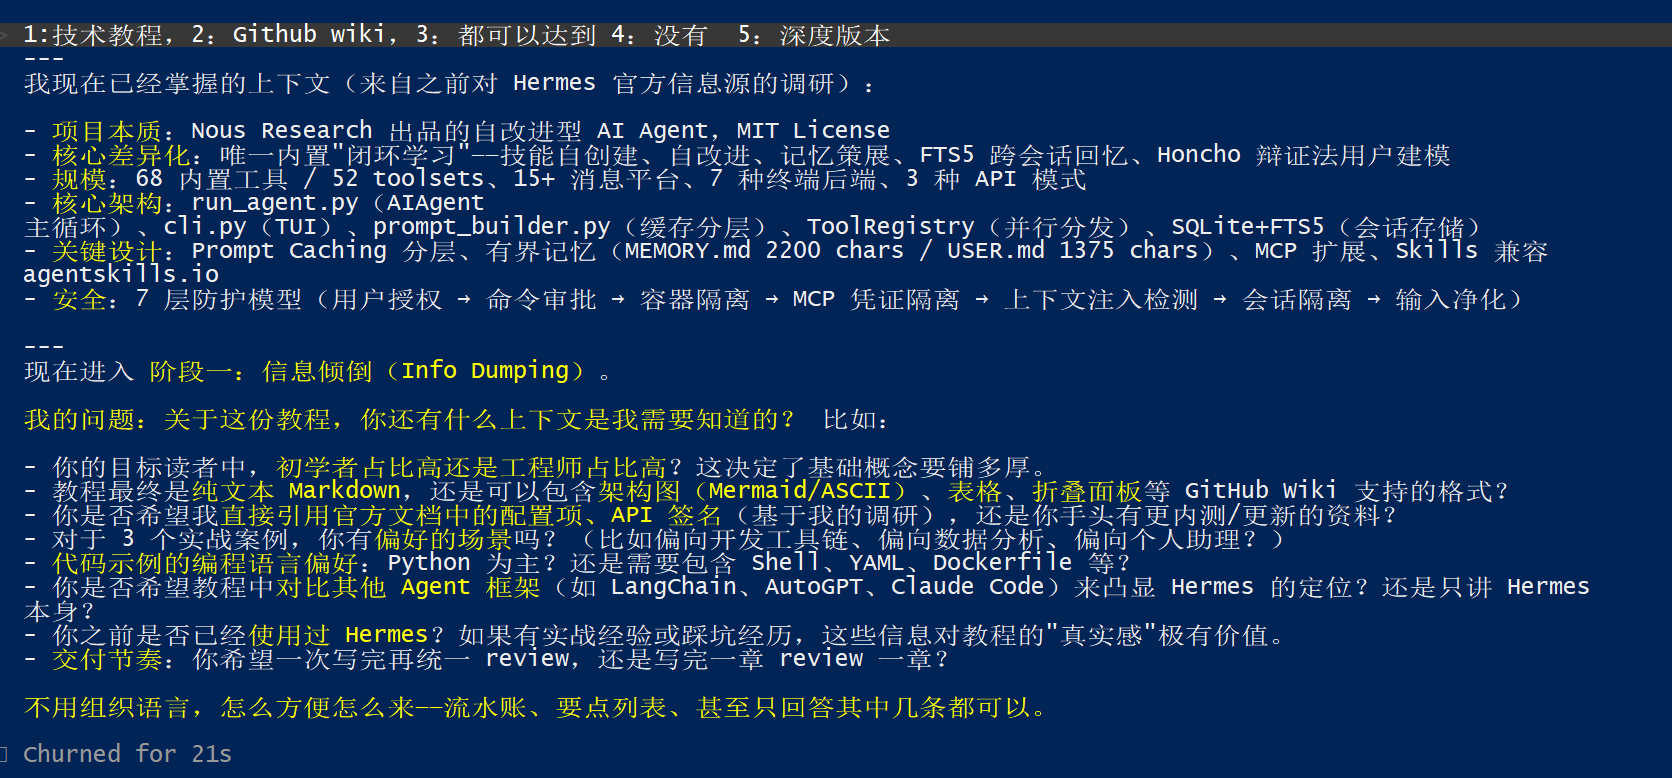
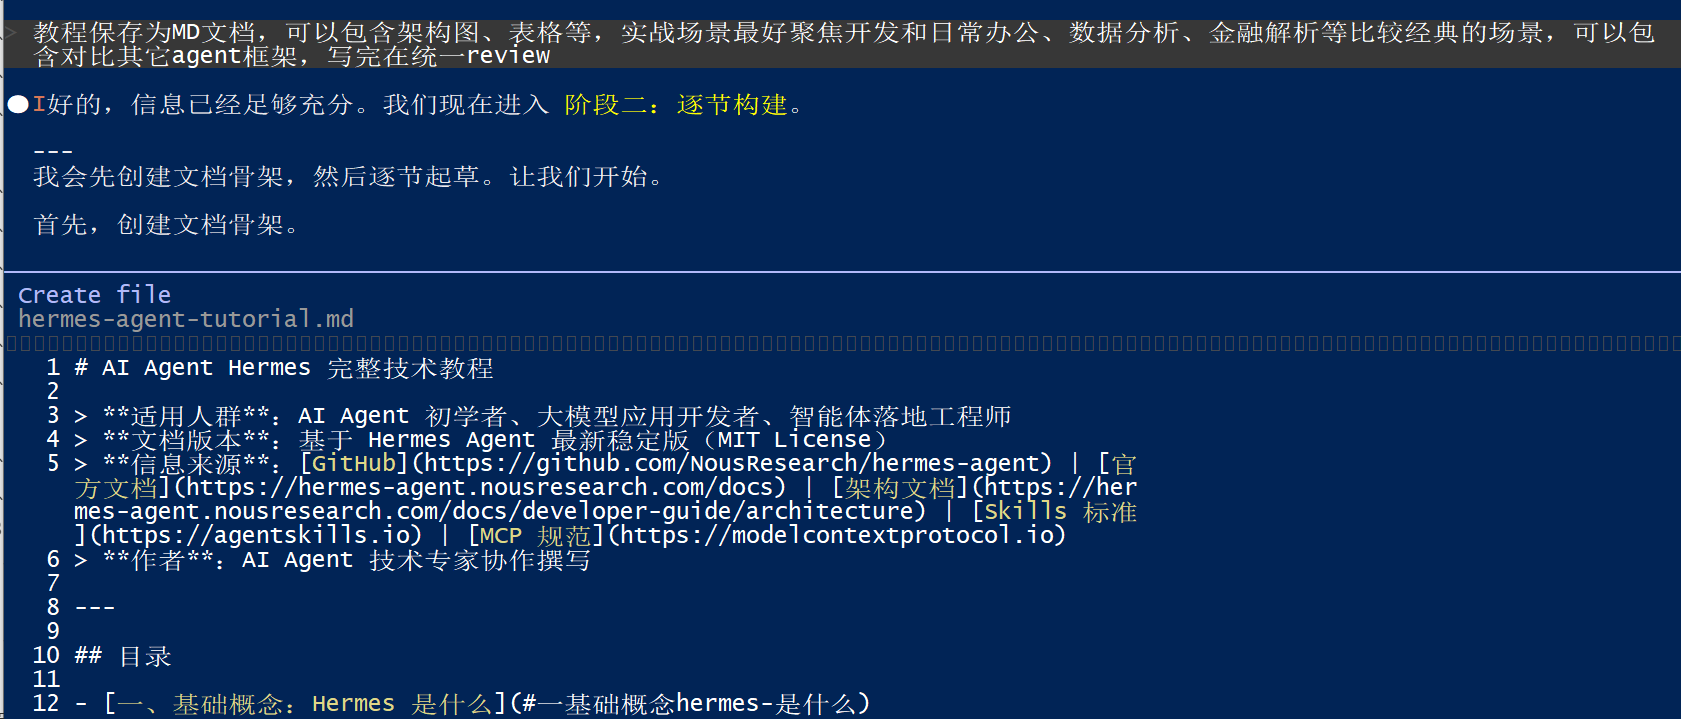
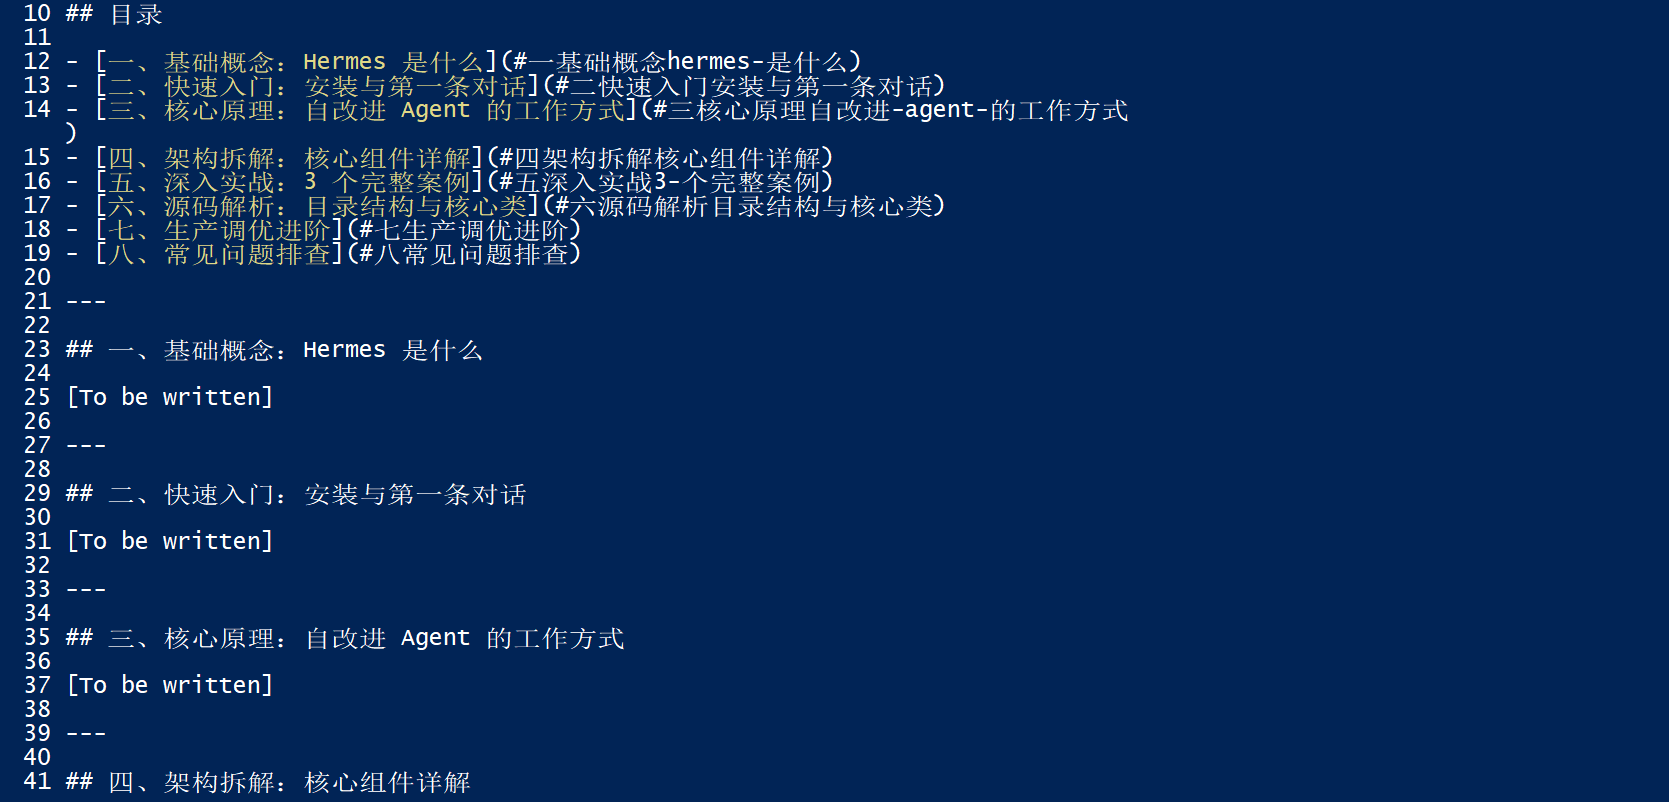
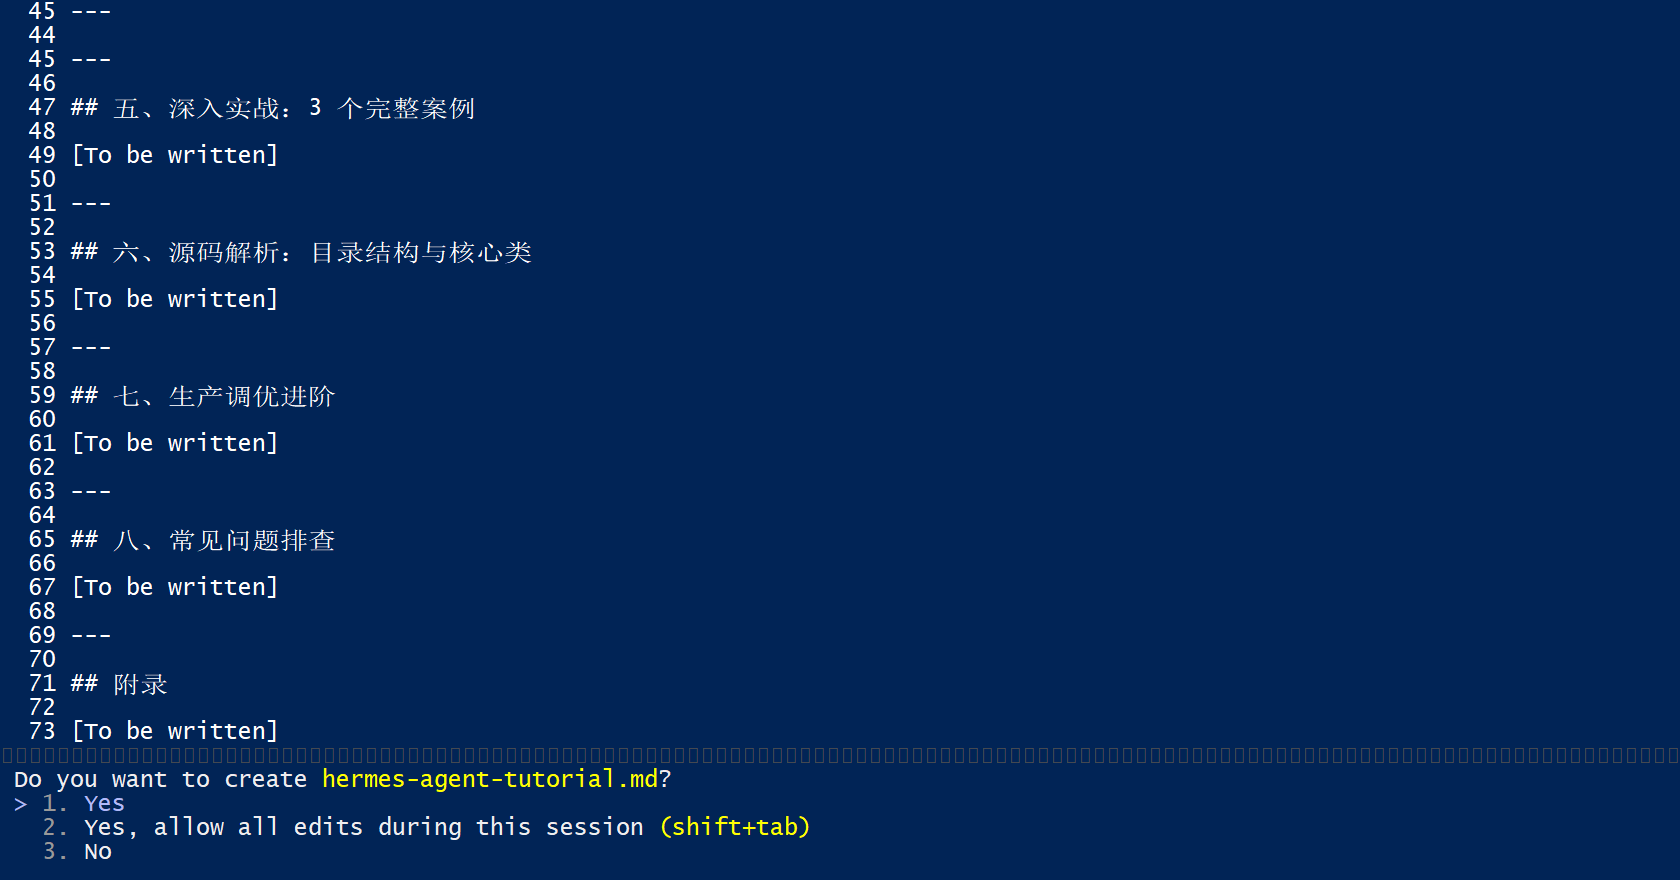
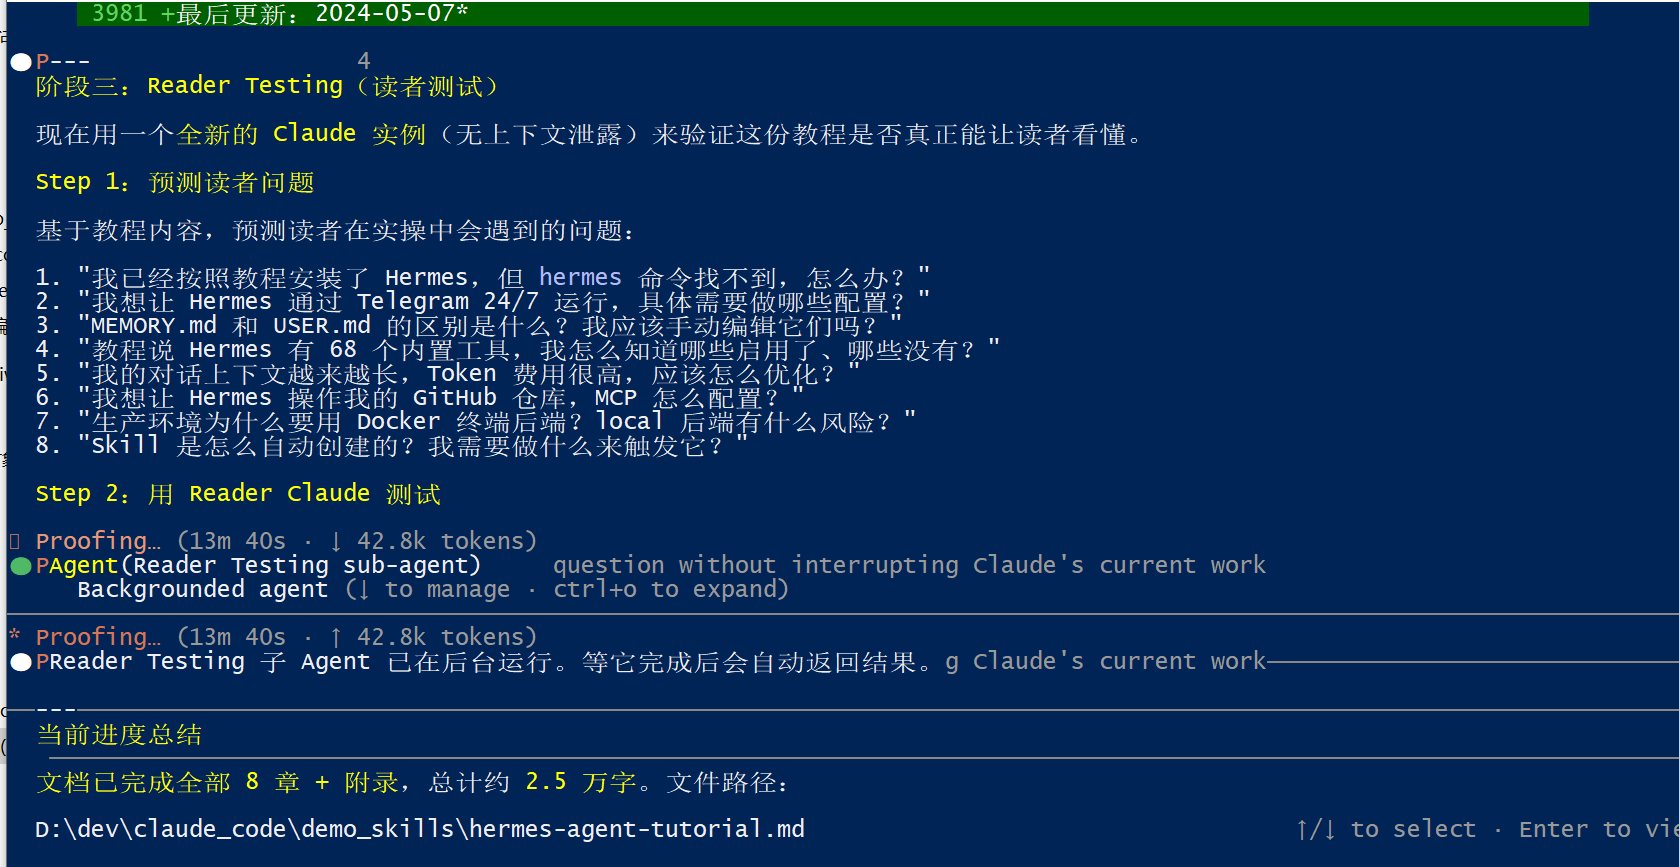
经测试,使用doc-coauthoring Skill 生成的《Hermes Agent的技术教程》,全文共计2.5万字;未使用该技能时,生成的教程仅8千字左右。同时,与未使用技能的版本相比,使用doc-coauthoring Skill 生成的教程在完整性、专业性上均有显著提升,内容更系统、逻辑更清晰,能更全面地覆盖Hermes Agent相关技术要点。
本次测试采用方舟codingplan套餐的kimi k2.6模型。
补充学习资源
如您想要系统建立 AI Agent 全栈开发能力,从概念认知到企业级项目落地、线上迭代优化,可以参考《栖微 AI Agent 工程师实战成长营》专栏。专栏以六阶成长路径组织内容,配套实战源码与持续更新的前沿案例,补齐 Demo 到生产环境之间的工程化短板。
Github 项目 :https://github.com/tinyseeking/tidy-agent-practice
欢迎大家一起探讨智能体开发相关问题。